Die Antwort vorweg: Wenn ein RAID oder NAS den Status degraded, critical, failed disk oder einen nicht abgeschlossenen Rebuild meldet und die Daten wichtig sind, starten Sie nicht blind einen weiteren Rebuild. Stoppen Sie alle Schreibvorgänge, dokumentieren Sie die Reihenfolge der Festplatten, erstellen Sie Screenshots der Meldungen und fahren Sie das System sicher herunter. Eine professionelle Wiederherstellung beginnt nicht mit dem Neuaufbau des Arrays auf den Originalfestplatten, sondern mit dem sektorweisen Klonen jeder einzelnen Festplatte und einer Offline-Rekonstruktion aus den Kopien – so gehen wir bei der Datenrettung von RAID-Systemen auch bei Synology und QNAP vor.
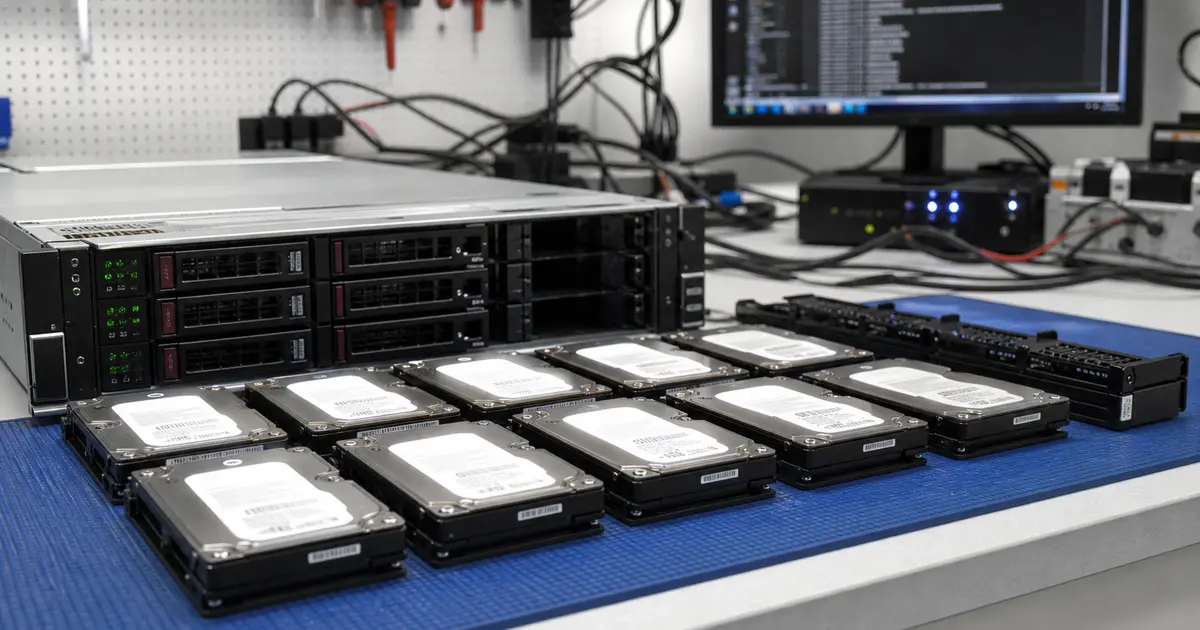
Ein Klick. 160 TB Kapazität. Vier Jahre Unternehmensprojekte. Und eine Entscheidung des Administrators, die auf den ersten Blick wie Routine wirkte: die defekte Festplatte austauschen und den Rebuild starten.
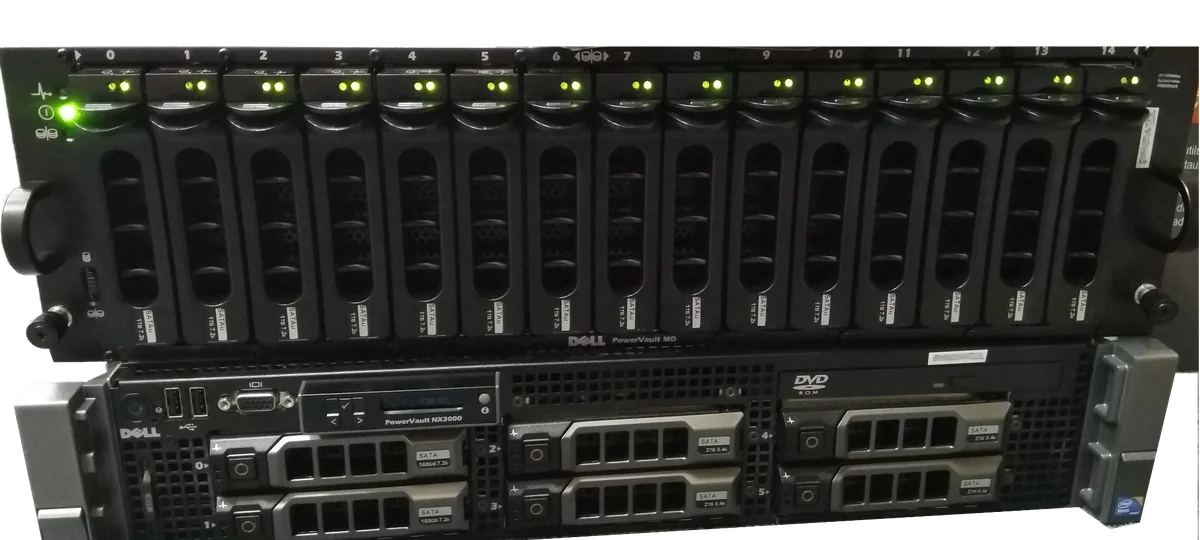
Genau so gelangte ein RAID-6-Verbund mit 20 Festplatten von einem Planungsbüro aus Brno zu uns. Auf dem NAS lagen CAD-Dokumentationen, historische Projekte und ein Teil der betrieblichen Sicherungen. RAID 6 ist grundsätzlich ein Verbund mit doppelter Parität und sollte daher den Ausfall von zwei Festplatten verkraften. Doch „sollte“ bedeutet nicht, dass ein altes Array ohne vorherige Prüfung gefahrlos neu aufgebaut werden kann.
Was bedeutet „Degraded RAID“?
Der Zustand degraded bedeutet nicht, dass die Daten verloren sind. Er bedeutet, dass das RAID einen Teil seiner Redundanz verloren hat und im Notbetrieb läuft.
- RAID 1: Eine gespiegelte Festplatte fehlt, die Daten befinden sich noch auf der anderen.
- RAID 5: Eine Festplatte fehlt; ein weiterer Fehler kann bereits den Verlust des Arrays bedeuten.
- RAID 6: Eine oder zwei Festplatten fehlen, doch bei zwei Ausfällen besteht keine Reserve für einen weiteren Fehler.
- RAID 10: Entscheidend ist, in welchem Spiegelpaar die Festplatte ausgefallen ist.
Der größte Irrtum besteht darin, einen degradierten Zustand als Aufforderung zu verstehen, um jeden Preis sofort einen Rebuild zu starten. Bei einem kleinen, neuen Array mit aktueller Datensicherung kann das sinnvoll sein. Bei einem NAS, das seit vier Jahren läuft, mehrere Dutzend Terabyte enthält und keine überprüfte externe Sicherung besitzt, ist es ein Glücksspiel.
Wann Sie es nicht selbst versuchen sollten und was wir tun
Ein eigener Wiederherstellungsversuch schadet bei einem degradierten Array vor allem dann, wenn:
- das Array Fehler auf einer weiteren Festplatte meldet (read error, timeout oder eine weitere failed disk) – während des Rebuilds wird die gesamte Oberfläche gelesen, was eine geschwächte Festplatte endgültig ausfallen lassen kann,
- das NAS nach einem Neustart eine Festplatte oder ein Volume nicht mehr erkennt oder eine Initialisierung beziehungsweise „repair“ anbietet – diese Optionen schreiben Metadaten, die für die Rekonstruktion des Arrays benötigt werden,
- eine Festplatte im Array klickt, das System einer Überspannung ausgesetzt war oder das NAS heruntergefallen ist – physisch beschädigte Komponenten dürfen nicht weiter belastet werden.
Fahren Sie das Array in diesem Fall sicher herunter, notieren Sie die Reihenfolge der Festplatten und überlassen Sie es unserer Datenrettung von RAID- und NAS-Systemen. Der Ablauf besteht aus drei Schritten:
- Annahme – Sie bringen die Festplatten oder das gesamte NAS in unser Labor in Brno-Židenice oder senden sie uns zu. Kennzeichnen Sie dabei die Reihenfolge der Einschübe und beschreiben Sie, welche Aktionen in der Verwaltung vorgenommen wurden.
- Diagnose – wir prüfen den Zustand jeder Festplatte und die Geometrie des Arrays. Eine einfache Erstbeurteilung eines RAID- oder NAS-Systems kann kostenlos sein. Die Analyse mehrerer Festplatten, die Rekonstruktion des Arrays sowie die Untersuchung gelöschter Daten oder Metadaten können kostenpflichtig sein; den Preis nennen wir Ihnen vor Beginn der kostenpflichtigen Arbeiten.
- Angebot mit Preis, danach die Arbeiten – Sie erhalten den Preis für die Datenrettung im Voraus. Erst nach Ihrer Zustimmung klonen wir die Festplatten und setzen das Array aus den Kopien zusammen. Die Originale werden nicht weiter belastet.
Ist es dringend? Rufen Sie unsere rund um die Uhr erreichbare Hotline unter +420 775 556 063 an.
Zeitlicher Ablauf des Ausfalls
In unserem Fall handelte es sich um ein Enterprise-NAS mit 20 Festplatten in einem RAID-6-Verbund. Das Array war mehrere Jahre ununterbrochen in Betrieb. Die Benutzer speicherten darauf sowohl laufende Projekte als auch Archivdaten.
Montagmorgen: Festplatte Nummer 7 fiel aus. Das Array wechselte in den Zustand degraded, die Daten waren jedoch weiterhin verfügbar. Der Administrator bestellte eine Ersatzfestplatte und plante den Austausch für den Abend.
Dienstagmorgen: Noch bevor die Ersatzfestplatte eintraf, meldete Festplatte Nummer 12 einen kritischen Fehler. Das RAID 6 war theoretisch weiterhin lesbar, besaß aber keinerlei Toleranz für einen weiteren Fehler.
Dienstagnachmittag: Die Ersatzfestplatte traf ein und der Rebuild wurde gestartet. Der Controller begann, die gesamte Oberfläche der verbliebenen Festplatten zu lesen, die Parität zu berechnen und eine neue Kopie der fehlenden Daten zu schreiben.
Nach dreißig Stunden: Der Rebuild stoppte an fehlerhaften Sektoren der Festplatte Nummer 5. Zuvor hatte sie unauffällig gewirkt. Das intensive Lesen während des Rebuilds brachte jedoch latente Fehler zum Vorschein, die im normalen Betrieb nicht sichtbar gewesen waren.
Mittwochmorgen: Das Array war offline und ließ sich mit üblichen Mitteln nicht mehr einbinden.
Genau in diesem Moment können ein weiterer Rebuild-Versuch, „force online“, eine Änderung der Festplattenreihenfolge oder die Initialisierung eines neuen Arrays auch jene Daten zerstören, die noch wiederherstellbar wären.
Warum ein Rebuild ein altes Array endgültig zerstören kann
Ein Rebuild ist keine Datenreparatur. Er ist ein massiver Belastungstest für alle verbliebenen Festplatten.
Im normalen Betrieb liest ein NAS nur aktive Dateien und Metadaten. Während eines Rebuilds muss der Controller dagegen große Teile der Oberfläche aller Festplatten lesen – oft stunden- oder tagelang ohne Unterbrechung. Gerade bei älteren Festplatten zeigen sich dann:
- latente fehlerhafte Sektoren,
- Zeitüberschreitungen beim Lesen,
- geschwächte Schreib-Lese-Köpfe,
- sich verschlechternde SMART-Werte,
- Probleme mit der Stromversorgung oder Kühlung eines Einschubs,
- Paritätsinkonsistenzen nach früheren Ausfällen.
Je größer die Festplatten sind, desto länger dauert der Rebuild und desto größer ist das Risikofenster. Bei RAID 5 ist die Situation noch kritischer, weil bereits ein weiterer Fehler während des Rebuilds das Ende des Arrays bedeuten kann. RAID 6 bietet eine größere, aber keine unbegrenzte Reserve. Wenn bereits zwei Festplatten ausgefallen sind und eine dritte Lesefehler liefert, reicht auch die doppelte Parität nicht mehr aus.
Was vor dem Rebuild hätte geschehen sollen
Ein sicheres Vorgehen bei einem wichtigen degradierten RAID sieht anders aus:
- Schreibvorgänge stoppen. Idealerweise werden Freigaben getrennt, Dienste deaktiviert sowie Virtualisierung und Datenbanken angehalten.
- Zustand dokumentieren. Screenshots der NAS-Verwaltung, Protokolle, Reihenfolge und Seriennummern der Festplatten, Einschübe, RAID-Typ, Stripe-Größe und Dateisystemtyp.
- SMART-Werte aller Festplatten prüfen. Nicht nur die Werte der Festplatte, die das NAS als defekt markiert hat.
- Datensicherung überprüfen. Nicht darauf vertrauen, dass sie „irgendwo vorhanden sein müsste“, sondern das letzte Backup tatsächlich öffnen und die Daten kontrollieren.
- Bei kritischen Daten vor dem Rebuild klonen. Jede Originalfestplatte sektorweise auf einen anderen Datenträger kopieren. Der Rebuild darf erst aus den Kopien oder nach einer eindeutigen Risikobewertung erfolgen.
Wenn Sie unsicher sind, ist es am sichersten, nichts weiter zu überschreiben. Das gilt für Synology, QNAP, TrueNAS, Linux mdadm, ZFS und Hardware-Controller von Dell, HP oder LSI.
Unser Vorgehen im Labor
Nach der Annahme kennzeichneten wir zunächst die Festplatten entsprechend ihrer ursprünglichen Positionen. Bei der RAID-Wiederherstellung ist die Reihenfolge entscheidend. Die Festplatten dürfen nicht vertauscht werden, eine automatische Initialisierung darf nicht gestartet und ein „repair“-Angebot in der Verwaltung nicht bestätigt werden.
Die erste Phase bestand im sektorweisen Klonen aller Festplatten. Defekte Festplatten werden mit einer anderen Strategie gelesen als intakte: zuerst stabile Bereiche, danach problematischere Stellen, bei Bedarf in umgekehrter Leserichtung und mit wiederholten Versuchen an schwachen Sektoren. Das Ziel ist kein makelloser SMART-Bericht. Ziel ist es, möglichst viele lesbare Sektoren zu sichern, bevor sich der Zustand der Festplatte weiter verschlechtert.
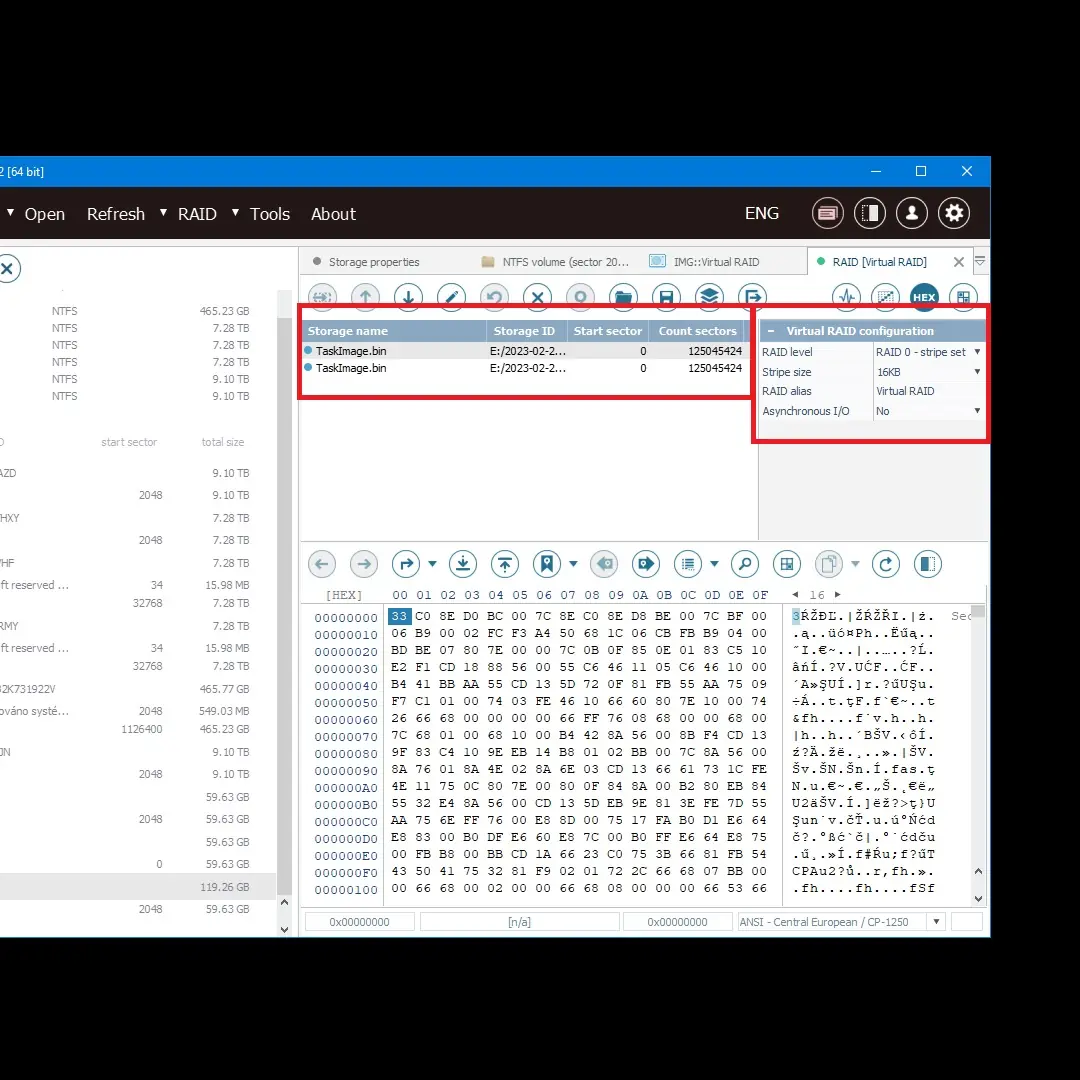
Die zweite Phase war die Offline-Analyse. Bei großen Arrays reicht es nicht zu wissen, dass „es ein RAID 6 war“. Wir benötigen die genaue Geometrie:
- Reihenfolge der Festplatten,
- Stripe-Größe,
- Paritätsrotation,
- Start-Offset,
- mögliche Metadaten des NAS-Herstellers,
- Zustand des Dateisystems auf dem Array.
Erst danach wird aus den Klonen ein virtuelles Array zusammengesetzt. Die Originale sollen in dieser Phase nicht mehr belastet werden. Wenn die Rekonstruktion nicht beim ersten Versuch gelingt, werden die Parameter auf den Kopien geändert – nicht auf den Festplatten des Kunden.
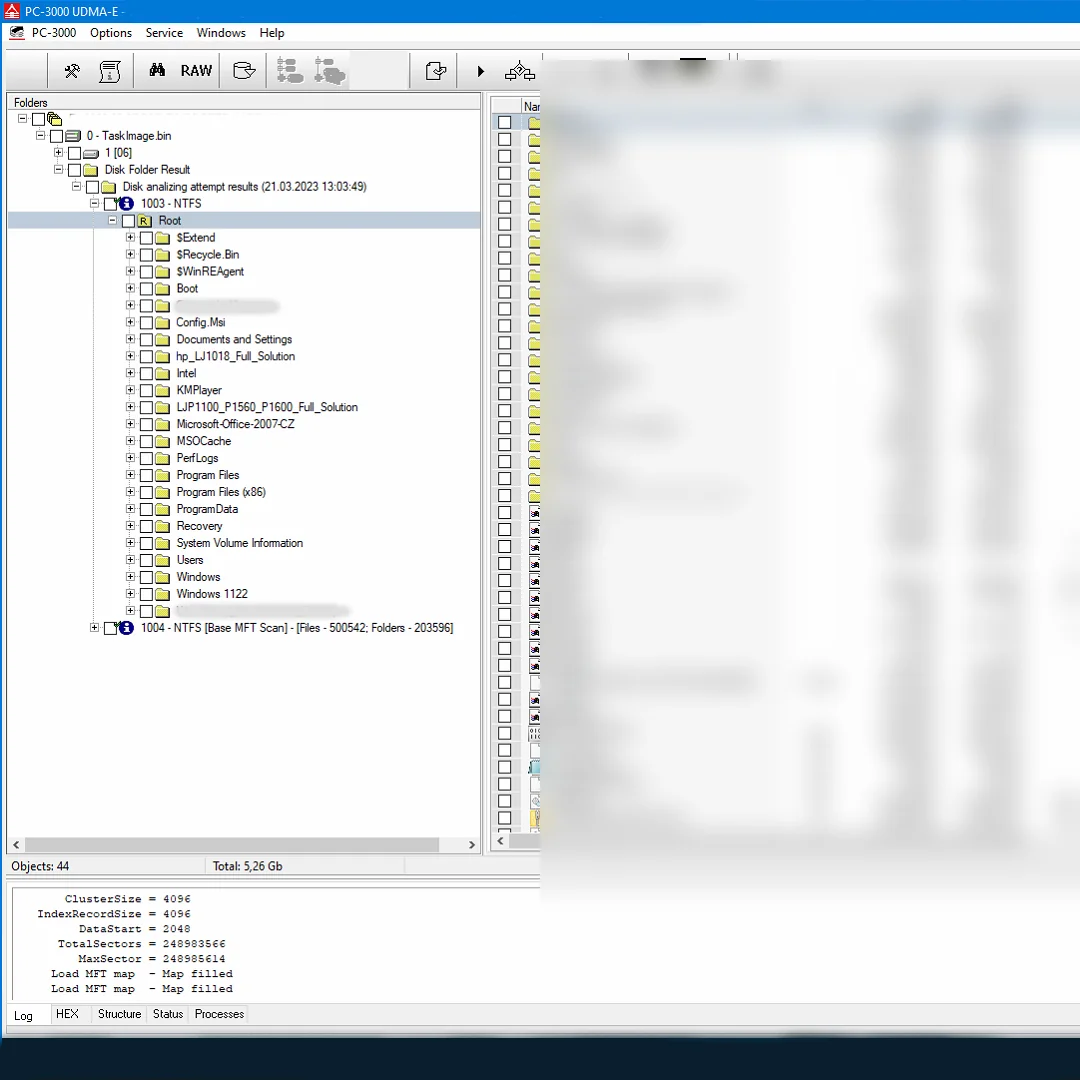
In diesem Fall konnten 100 % der Kundendaten wiederhergestellt werden. Der Kunde überprüfte zufällig ausgewählte CAD-Projekte aus mehreren Jahren, Referenzdateien und Archivordner. Aktuelle Projekte mit Priorität A extrahierten wir vor dem restlichen Array, damit das Unternehmen seine Arbeit fortsetzen konnte, während die vollständige Rekonstruktion noch lief.
Eine ausführlichere technische Fallstudie finden Sie auf der Seite zur Datenrettung eines RAID-6-NAS mit 20 Festplatten.
Was tun, wenn das RAID gerade einen Fehler meldet?
Wenn Sie diesen Artikel lesen, während das NAS piept oder die Verwaltung rote Warnmeldungen anzeigt:
- Starten Sie den Rebuild nicht wiederholt. Ein fehlgeschlagener Rebuild ist Warnung genug.
- Erstellen Sie kein neues Array auf denselben Festplatten. Die Initialisierung kann Metadaten überschreiben.
- Ändern Sie nicht die Reihenfolge der Festplatten. Fotografieren Sie die Einschübe und notieren Sie Steckplätze und Seriennummern.
- Verhindern Sie Schreibzugriffe auf das Array. Jede neue Datei macht den Zustand des Dateisystems komplizierter.
- Kombinieren Sie keine Anleitungen aus verschiedenen Foren. mdadm, ZFS, Synology SHR, QNAP LVM und Hardware-RAID verwenden unterschiedliche Metadatenstrukturen.
- Überprüfen Sie eine vorhandene Datensicherung. Dateien tatsächlich zu öffnen ist aussagekräftiger, als nur zu sehen, dass der Backup-Auftrag „abgeschlossen“ wurde.
Wenn es um Daten geht, deren Verlust Sie sich nicht leisten können, stoppen Sie vor jeder Aktion, die auf die Festplatten schreibt. Die Erfolgsaussichten einer Datenrettung sind am höchsten, solange der ursprüngliche Zustand noch nicht überschrieben wurde.
RAID ist keine Datensicherung
RAID sorgt für Verfügbarkeit. Eine Datensicherung ermöglicht die Rückkehr zu den Daten nach einer Katastrophe.
Ein RAID kann den Betrieb aufrechterhalten, wenn eine Festplatte ausfällt und Sie weiterarbeiten müssen. Es schützt jedoch nicht vor dem Löschen eines Ordners, Ransomware, Fehlern eines Administrators, einem defekten Controller, Feuer, Wasserschäden oder einem fehlgeschlagenen Rebuild. Für Unternehmensdaten ist deshalb folgende Kombination sinnvoll:
- RAID/NAS für die betriebliche Verfügbarkeit,
- regelmäßige Scrubs oder Patrol Reads,
- Überwachung von SMART-Werten und Temperaturen,
- Offline- oder Offsite-Backups,
- Wiederherstellungstests zumindest für kritische Ordner.
Wenn das NAS der einzige Ort ist, an dem Ihre Daten existieren, handelt es sich nicht um eine Datensicherung. Es ist lediglich die einzige Kopie in einem teureren Gehäuse.
Kurze FAQ
Mein Synology/QNAP befindet sich im Zustand „degraded“. Soll ich eine neue Festplatte einsetzen?
Prüfen Sie zuerst den Zustand aller Festplatten und die Datensicherung. Wenn die Daten wichtig und das Array älter ist, sollten Sie das Vorgehen vor dem Rebuild fachlich abklären. Durch das Einsetzen einer Festplatte wird häufig automatisch ein Prozess gestartet, der sich nicht ohne Weiteres rückgängig machen lässt.
Der Rebuild läuft bereits. Soll ich ihn stoppen?
Das hängt vom Zustand ab. Wenn er fehlerfrei läuft und Sie über eine überprüfte Datensicherung verfügen, kann er abgeschlossen werden. Treten jedoch Lesefehler, Timeouts, eine weitere ausgefallene Festplatte oder ungewöhnliche Geräusche auf, kann die zusätzliche Belastung Schaden verursachen. In diesem Fall sollten Sie Schreibvorgänge stoppen, den Zustand dokumentieren und das Klonen der Festplatten veranlassen.
Kann ddrescue zu Hause helfen?
Bei einer einzelnen Festplatte kann ddrescue ein nützliches Werkzeug sein, sofern Sie genau wissen, was Sie tun, und auf einen anderen Datenträger kopieren. Bei einem RAID genügt es jedoch nicht, „irgendetwas“ zu klonen. Sie benötigen die korrekte Reihenfolge der Festplatten, den Offset, die Parität und das Dateisystem. Ein fehlerhaftes Vorgehen kann Metadaten überschreiben oder den Zustand der Festplatten verschlechtern.
Wie viel kostet eine RAID-Datenrettung?
Das hängt von der Anzahl und Kapazität der Festplatten, dem RAID-Typ, dem Zustand der Datenträger und dem Umfang der erforderlichen manuellen Rekonstruktion ab. Eine einfache Erstbeurteilung eines RAID/NAS kann kostenlos sein. Die Analyse mehrerer Festplatten, die Rekonstruktion des Arrays sowie die Untersuchung gelöschter Daten oder Metadaten können kostenpflichtig sein – den Preis nennen wir Ihnen vor Beginn der kostenpflichtigen Arbeiten, und vor der eigentlichen Wiederherstellung erhalten Sie einen Kostenvoranschlag. Beginnen können Sie mit einer Anfrage zur RAID-Datenrettung oder über unser Kontaktformular.
Wenn Ihr RAID degradiert ist, der Rebuild fehlgeschlagen ist oder das NAS offline bleibt, versuchen Sie keine weiteren Reparaturen auf eigene Faust. Rufen Sie uns unter +420 775 556 063 an, schreiben Sie an zachranadat@ithope.cz oder senden Sie uns eine Beschreibung über das Kontaktformular. Unser Labor befindet sich in Brno-Židenice; RAID- und NAS-Fälle bearbeiten wir aus der gesamten Tschechischen Republik.
Wo Sie uns finden
ITHOPE ist eine Firma aus Brno, Tschechien: wir machen Datenrettung von Festplatten, RAID und NAS, PC- und Notebook-Service und IT für Unternehmen, alles im eigenen Labor in der Viniční 3587/216, 615 00 Brno.
Telefon +420 775 556 063 (rund um die Uhr). Das Gerät können Sie persönlich bringen oder per Kurier schicken (Zásilkovna, PPL).