Коротка відповідь: Якщо RAID або NAS повідомляє про degraded, critical, failed disk чи незавершений rebuild, а дані важливі, не запускайте ще один rebuild навмання. Припиніть запис, зафіксуйте порядок дисків, зробіть знімки екрана з повідомленнями та безпечно вимкніть масив. Професійне відновлення починається не з перебудови масиву на оригінальних дисках, а з посекторного клонування кожного диска й офлайн-реконструкції з копій — саме так ми виконуємо відновлення даних із RAID, зокрема для Synology та QNAP.
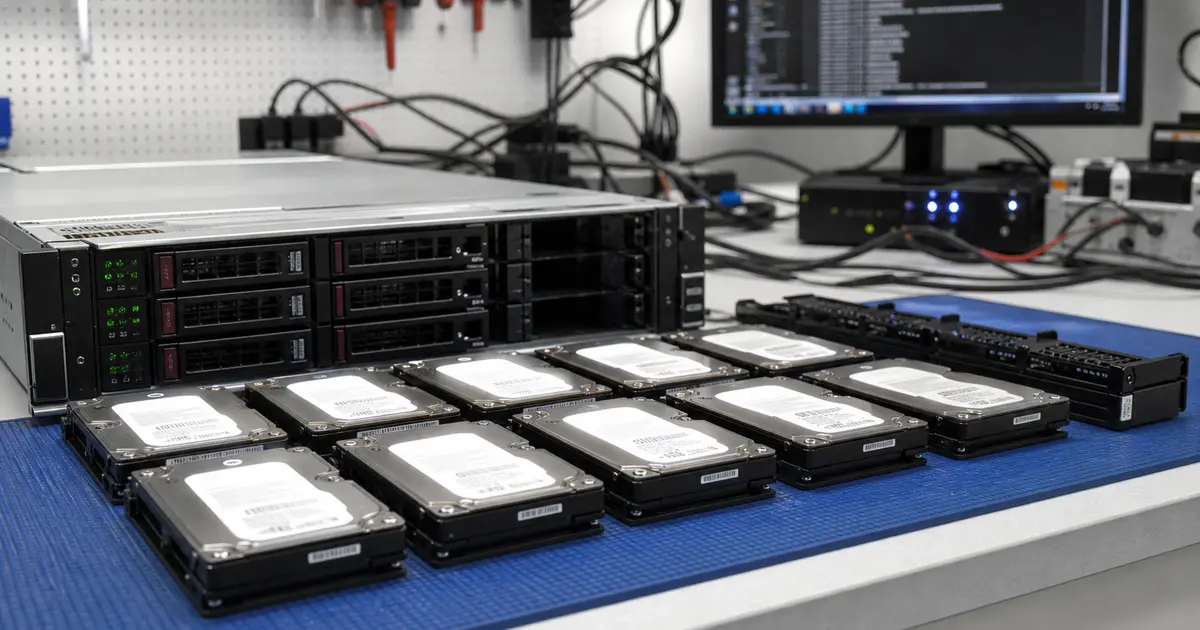
Один клік. 160 ТБ місткості. Чотири роки корпоративних проєктів. І рішення адміністратора, яке на перший погляд здавалося звичайною процедурою: замінити несправний диск і запустити rebuild.
Саме так до нас потрапив 20-дисковий масив RAID 6 із проєктної компанії у Брно. На NAS зберігалися CAD-документація, архівні проєкти та частина операційних резервних копій. RAID 6 за своєю суттю є масивом із подвійною парністю, тож він має витримати відмову двох дисків. Проте «має витримати» не означає, що старий масив можна безпечно перебудовувати без попередньої перевірки.
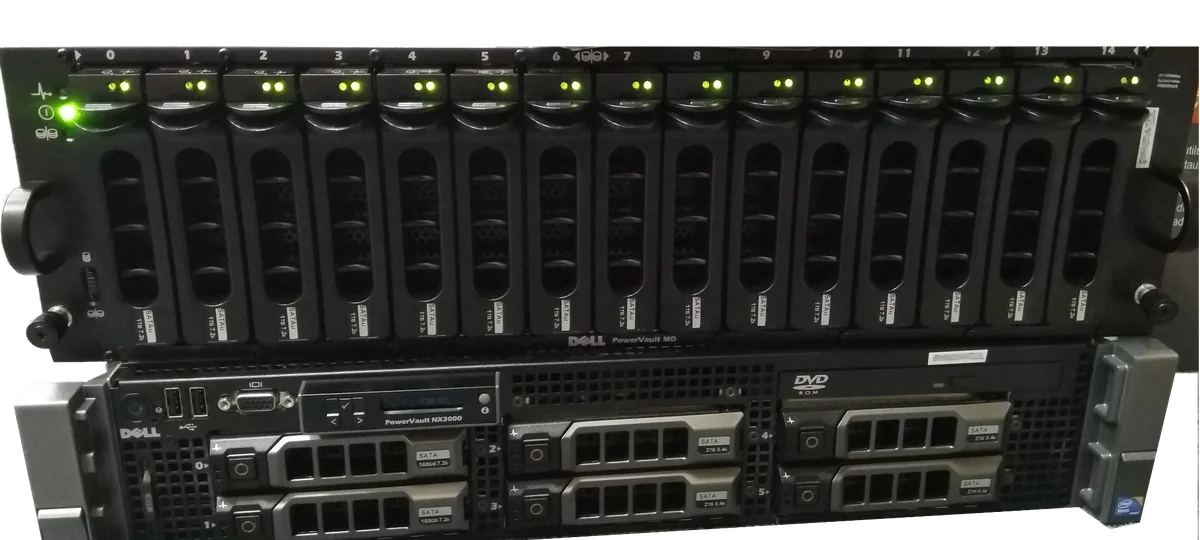
Що означає degraded RAID
Стан degraded не означає, що дані втрачено. Він означає, що RAID втратив частину надлишковості та працює в аварійному режимі.
- RAID 1: один із дзеркальних дисків відсутній, дані залишаються на другому.
- RAID 5: один диск відсутній, а наступна помилка вже може призвести до втрати масиву.
- RAID 6: відсутній один або два диски, але після відмови двох дисків запасу для наступної помилки вже немає.
- RAID 10: усе залежить від того, в якій саме дзеркальній парі вийшов із ладу диск.
Найбільша помилка — сприймати стан degraded як заклик за будь-яку ціну негайно запустити rebuild. Для невеликого нового масиву зі свіжою резервною копією це може бути розумним рішенням. Але для NAS, який безперервно працював чотири роки, містить десятки терабайтів даних і не має перевіреної зовнішньої резервної копії, це ризикована гра.
Коли не варто діяти самостійно і що зробимо ми
Самостійна спроба відновити деградований масив особливо небезпечна, якщо:
- масив повідомляє про помилки на іншому диску (read error, timeout, ще один failed disk) — під час rebuild зчитується вся поверхня, і слабкий диск може остаточно вийти з ладу;
- після перезапуску NAS не розпізнає диск або том чи пропонує ініціалізацію або «repair» — ці дії записують метадані, за якими складається масив;
- диск у масиві клацає, сталося перенапруження або NAS упав — фізично пошкоджені компоненти не можна навантажувати далі.
У такому разі безпечно вимкніть масив, запишіть порядок дисків і передайте його на відновлення даних із RAID та NAS. Процес складається з трьох етапів:
- Приймання — привезіть диски або весь NAS до лабораторії у Брно-Жиденіце чи надішліть їх, позначивши порядок відсіків і описавши дії, які виконувалися в панелі керування.
- Діагностика — ми перевіримо стан кожного диска та геометрію масиву. Просте первинне оцінювання RAID або NAS може бути безплатним; аналіз кількох дисків, реконструкція масиву, відновлення видалених даних чи метаданих можуть бути платними, про що ми повідомимо до початку оплачуваних робіт.
- Цінова пропозиція, потім робота — ви заздалегідь отримаєте вартість відновлення. Лише після вашої згоди ми клонуємо диски та складаємо масив із копій, більше не навантажуючи оригінали.
Терміново? Телефонуйте на цілодобову лінію +420 775 556 063.
Хронологія відмови
У нашому випадку йшлося про корпоративний NAS із 20 дисками в RAID 6. Масив безперервно працював кілька років. Користувачі зберігали на ньому як активні проєкти, так і архів.
У понеділок уранці: вийшов із ладу диск № 7. Масив перейшов у стан degraded, але дані залишалися доступними. Адміністратор замовив новий диск і запланував заміну на вечір.
У вівторок уранці: ще до доставлення нового диска про критичну помилку повідомив диск № 12. RAID 6 теоретично все ще можна було прочитати, але він уже не витримав би жодної наступної помилки.
У вівторок після обіду: доставили новий диск і запустили rebuild. Контролер почав зчитувати всю поверхню решти дисків, обчислювати парність і записувати нову копію відсутніх даних.
Через тридцять годин: rebuild зупинився на пошкоджених секторах диска № 5. До цього диск здавався справним. Однак інтенсивне зчитування під час rebuild виявило приховані помилки, які не проявлялися за звичайної роботи.
У середу вранці: масив був офлайн, і підключити його звичайними засобами вже не вдавалося.
Саме в цей момент наступна спроба rebuild, команда «force online», зміна порядку дисків або ініціалізація нового масиву можуть знищити навіть ті дані, які ще можна відновити.
Чому rebuild остаточно руйнує старий масив
Rebuild — це не виправлення даних. Це масштабний стрес-тест усіх дисків, що залишилися.
За звичайної роботи NAS зчитує лише активні файли та метадані. Під час rebuild контролер мусить пройти величезну частину поверхні всіх дисків, часто безперервно працюючи від кількох годин до кількох днів. Саме тоді на старих дисках проявляються:
- приховані пошкоджені сектори;
- тайм-аути під час читання;
- слабкі головки;
- погіршені показники SMART;
- проблеми з живленням або охолодженням відсіку;
- невідповідність парності після попередніх збоїв.
Що більша місткість дисків, то довше триває rebuild і то більшим є період підвищеного ризику. Для RAID 5 ситуація ще небезпечніша, оскільки одна додаткова помилка під час rebuild може стати кінцем масиву. RAID 6 має більший запас, але він не безмежний. Якщо два диски вже відсутні, а третій починає повертати помилки, подвійної парності більше не вистачає.
Що слід було зробити перед rebuild
Безпечна робота з важливим RAID у стані degraded має виглядати інакше:
- Припинити запис. В ідеалі — відключити спільні папки, вимкнути служби, зупинити віртуалізацію та бази даних.
- Зафіксувати стан. Зробити знімки екрана панелі керування NAS, зберегти журнали, записати порядок дисків, серійні номери, відсіки, тип RAID, розмір stripe і тип файлової системи.
- Перевірити SMART усіх дисків. Не лише того, який NAS позначив як несправний.
- Перевірити резервну копію. Не просто припустити, що вона «десь має бути», а відкрити останню копію та перевірити дані.
- Для критично важливих даних клонувати диски перед rebuild. Кожен оригінальний диск потрібно посекторно зчитати на інший носій. Rebuild слід виконувати лише з копій або після чіткого оцінювання ризику.
Якщо ви не впевнені, найбезпечніше рішення — більше нічого не записувати на диски. Це стосується Synology, QNAP, TrueNAS, Linux mdadm, ZFS і апаратних контролерів Dell/HP/LSI.
Як ми працювали в лабораторії
Після приймання ми спочатку позначили диски відповідно до їхніх початкових позицій. Під час відновлення RAID порядок має вирішальне значення. Диски не перемішують, автоматичну ініціалізацію не запускають, а пропозицію «repair» у панелі керування не приймають.
Першим етапом було посекторне клонування всіх дисків. Несправні диски зчитуються за іншою стратегією, ніж справні: спочатку стабільні ділянки, потім проблемніші місця, за потреби — читання у зворотному напрямку та повторні спроби зчитування слабких секторів. Мета полягає не в отриманні гарного звіту SMART, а в тому, щоб зчитати якомога більше секторів до подальшого погіршення стану диска.
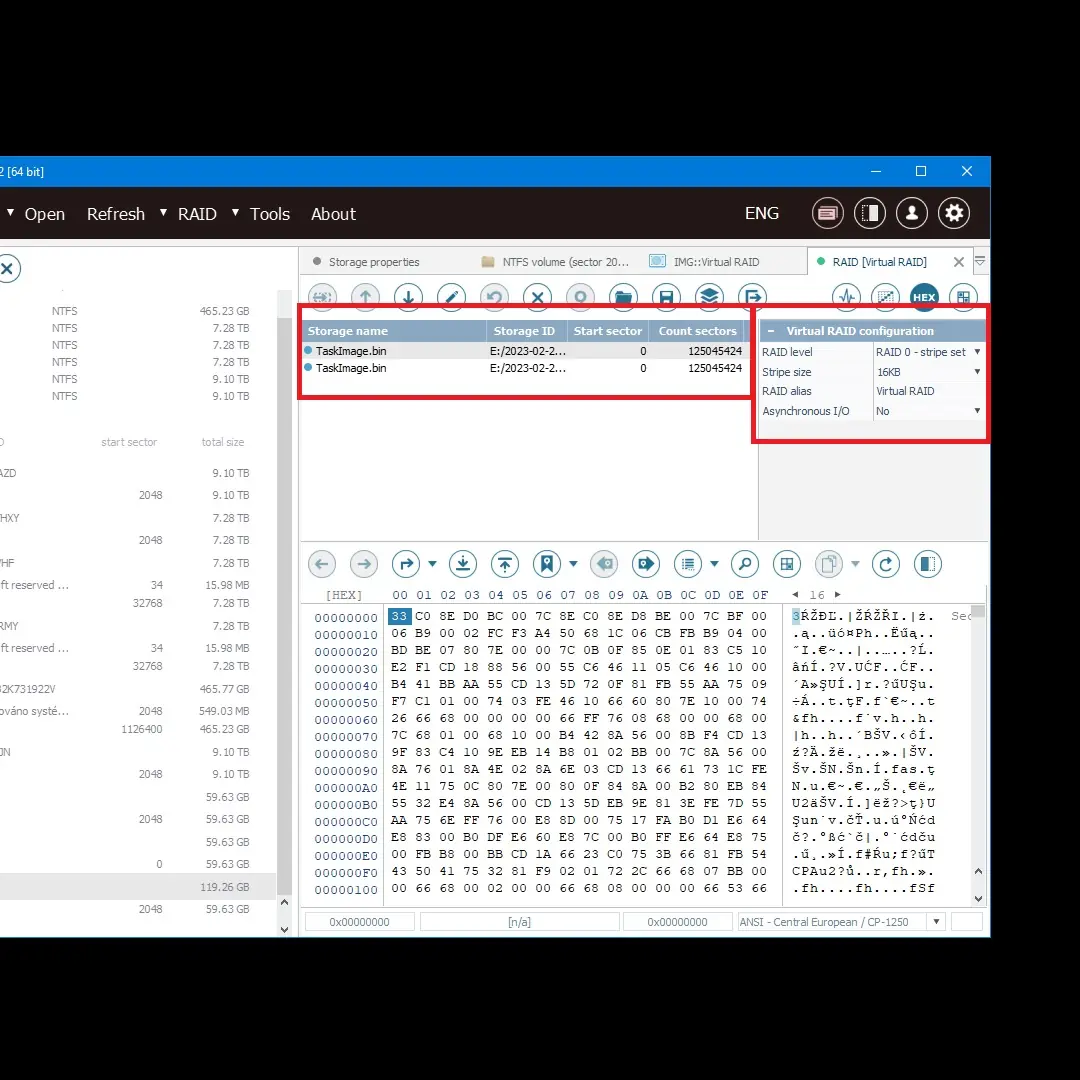
Другим етапом був офлайн-аналіз. Для великих масивів недостатньо знати, що «це був RAID 6». Нам потрібна точна геометрія:
- порядок дисків;
- stripe size;
- parity rotation;
- start offset;
- можливі метадані виробника NAS;
- стан файлової системи над масивом.
Лише після цього з клонів складається віртуальний масив. На цьому етапі ми вже не хочемо навантажувати оригінали. Якщо реконструкція не вдається з першої спроби, параметри змінюють на копіях, а не на дисках клієнта.
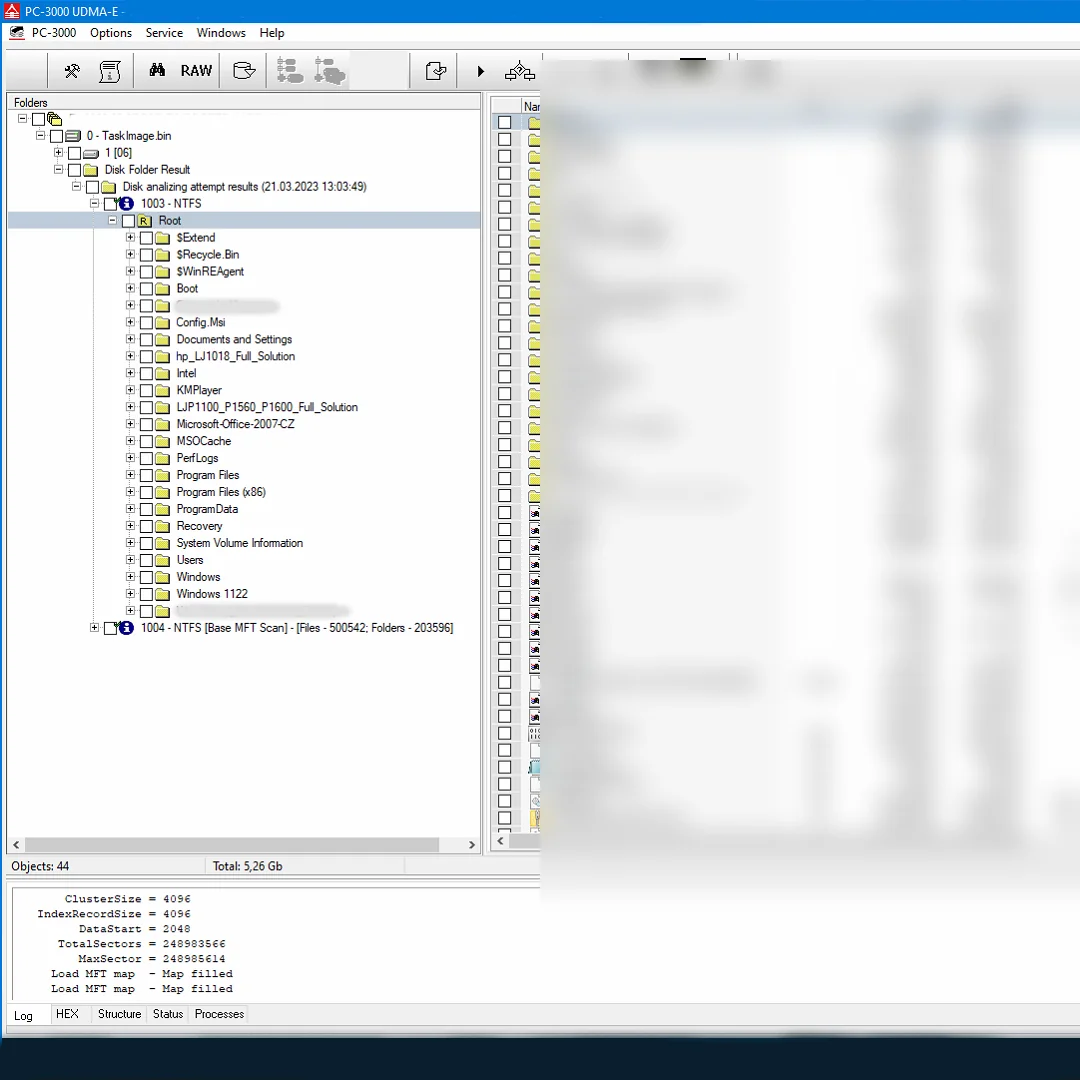
У цьому випадку вдалося відновити 100 % даних клієнта. Клієнт вибірково перевірив CAD-проєкти за кілька років, пов’язані файли й архівні папки. Актуальні проєкти з пріоритетом A ми відновили раніше за решту масиву, щоб компанія могла продовжити роботу, поки тривала повна реконструкція.
Докладніший технічний опис випадку наведено на сторінці відновлення даних із 20-дискового RAID 6 у NAS.
Що робити, якщо RAID саме зараз повідомляє про помилку
Якщо ви читаєте цю статтю, коли NAS подає звуковий сигнал або панель керування підсвічується червоним:
- Не запускайте rebuild повторно. Однієї невдалої спроби rebuild достатньо, щоб сприйняти її як серйозне попередження.
- Не створюйте новий масив на тих самих дисках. Ініціалізація може перезаписати метадані.
- Не змінюйте порядок дисків. Сфотографуйте відсіки, запишіть номери слотів і серійні номери.
- Не записуйте нічого на масив. Кожен новий файл ускладнює стан файлової системи.
- Не поєднуйте інструкції з різних форумів. mdadm, ZFS, Synology SHR, QNAP LVM та апаратний RAID мають різні структури метаданих.
- Якщо є резервна копія, перевірте її. Відкрити файли краще, ніж просто побачити, що завдання резервного копіювання «завершилося».
Якщо йдеться про дані, втрату яких ви не можете собі дозволити, зупиніться перед будь-якою дією, що записує щось на диски. Відновлення даних має найбільші шанси на успіх, поки початковий стан ще не перезаписано.
RAID — це не резервна копія
RAID забезпечує доступність. Резервна копія дає змогу повернути дані після катастрофи.
RAID може допомогти, коли один диск виходить із ладу, а вам потрібно продовжувати роботу. Але він не захистить від видалення папки, програм-вимагачів, помилки адміністратора, несправності контролера, пожежі, затоплення чи збою rebuild. Тому для корпоративних даних доцільно поєднувати:
- RAID/NAS для операційної доступності;
- регулярний scrub або patrol read;
- моніторинг SMART і температури;
- офлайн- або зовнішню резервну копію;
- тестове відновлення принаймні критично важливих папок.
Якщо NAS — єдине місце, де зберігаються ваші дані, це не резервна копія. Це єдина копія в дорожчій коробці.
Короткі відповіді на часті запитання
Мій Synology/QNAP перебуває у стані degraded. Чи слід вставити новий диск?
Спочатку перевірте стан усіх дисків і резервну копію. Якщо дані важливі, а масив старий, безпечніше проконсультуватися щодо подальших дій до запуску rebuild. Встановлення диска часто автоматично запускає процес, який уже не можна легко скасувати.
Rebuild уже триває. Чи слід його зупинити?
Це залежить від стану масиву. Якщо процес відбувається без помилок і ви маєте перевірену резервну копію, він може завершитися успішно. Якщо з’являються read errors, тайм-аути, ще один failed disk або незвичні звуки, подальше навантаження може зашкодити. У такій ситуації краще припинити запис, зафіксувати стан і перейти до клонування.
Чи допоможе ddrescue у домашніх умовах?
Для одного диска ddrescue може бути корисним інструментом, якщо ви розумієте свої дії та зчитуєте дані на інший носій. Проте для RAID недостатньо просто клонувати «щось». Потрібно знати правильний порядок дисків, offset, парність і файлову систему. Помилкові дії можуть перезаписати метадані або погіршити стан дисків.
Скільки коштує відновлення даних із RAID?
Це залежить від кількості дисків, місткості, типу RAID, стану носіїв і обсягу необхідної ручної реконструкції. Просте первинне оцінювання RAID/NAS може бути безплатним; аналіз кількох дисків, реконструкція масиву, відновлення видалених даних або метаданих можуть бути платними — вартість ми повідомимо до початку оплачуваних робіт, а перед самим відновленням ви отримаєте попередню оцінку. Розпочати можна із запиту на відновлення даних із RAID або через сторінку контактів.
Якщо ваш RAID перебуває у стані degraded, rebuild завершився невдало або NAS перейшов в офлайн, не намагайтеся виконувати подальший ремонт навмання. Телефонуйте за номером +420 775 556 063, пишіть на zachranadat@ithope.cz або надішліть опис через сторінку контактів. Наша лабораторія розташована у Брно-Жиденіце, а випадки з RAID/NAS ми приймаємо з усієї Чеської Республіки.
Де нас знайти
ITHOPE — компанія з Брно, Чехія: ми робимо відновлення даних з дисків, RAID і NAS, сервіс ПК та ноутбуків та IT для бізнесу, усе у власній лабораторії за адресою Viniční 3587/216, 615 00 Brno.
Телефон +420 775 556 063 (цілодобово). Пристрій можна привезти особисто або надіслати курʼєром (Zásilkovna, PPL).