
Většina rozpadlých polí, která k nám dorazí, nespadla sama od sebe — spadla během druhého nebo třetího pokusu o rebuild. Pokud jste u toho teď: zastavte zápis, pole vypněte a nechte disky ve stejných slotech. Než začnete cokoli zkoušet, projděte si podrobný návod co u rozpadlého RAID pole zvládnete sami a kde je hranice. Rekonstrukci pole děláme ve vlastní laboratoři v Brně-Židenicích a diagnostika je zdarma — zavolejte NONSTOP na +420 775 556 063 a stav pole projdeme po telefonu.
Degradované, nebo rozpadlé pole — od toho se odvíjí všechno
První otázka, kterou s vámi po telefonu vyřešíme, není značka NAS, ale stav pole.
- Degradované pole běží dál a data jsou přístupná, jen chybí redundance.
mdadm --detailhlásíclean, degraded, NAS píše „Degraded” nebo „Snížená ochrana”. Tady máte čas — nejlepší první krok je zkopírovat data pryč, ne spustit rebuild. - Rozpadlé (offline) pole se nesestaví, svazek chybí,
cat /proc/mdstatukazujeinactive, hardwarový řadič hlásí Offline nebo Failed. Tady je každý další start riziko a vlastní pokusy končí.
K tomu jedna věc, kterou zákazníci zjišťují až v této chvíli: RAID nikdy nebyl záloha. Neochrání před smazáním souborů, ransomwarem, selháním řadiče, který na pole zapíše nesmyslná metadata, ani před reinicializací pole. Jakmile se pole dostane do stavu offline, jeho obnova vyžaduje zásah specialisty bez ohledu na to, jak vysoká úroveň RAID byla použita.
Typické scénáře selhání, které vidíme nejčastěji
Vypadl druhý disk během rebuildu. Admin vymění vadný disk a řadič musí kvůli dopočtu přečíst každý sektor všech zbylých ploten. Disky, které roky běžely bez chyby, protože se na slabá místa nikdy netrefily, pod touto zátěží začnou chrlit chybové sektory. Pole vypadne úplně. Rozebráno v článku proč rebuild zabíjí RAID pole.
Rebuild se zasekl. Nespustí se, nebo se po desítkách hodin zastaví na pár procentech a nepokračuje — řadič narazil na špatný sektor a neví, jak ho obejít. Pokračovat silou znamená riskovat zničení mechaniky čtecích hlav.
Selhal řadič a pole má proprietární layout. Mrtvý řadič rozhodí metadata. Nový řadič disky načte, ale bez znalosti původního stripe offsetu a paritní rotace nabídne jen „Foreign configuration” a nutnost inicializace.
Lidská chyba. Někdo odpojí špatný disk, přehodí pozice v šachtách a spustí pole — nebo provede reinicializaci při pohledu na chybovou hlášku.
Výpadek více disků naráz. Selhání zdroje nebo backplane v NAS zabije najednou tři až čtyři disky. Pole se pak tváří, že logická jednotka je prázdná nebo nepřístupná.
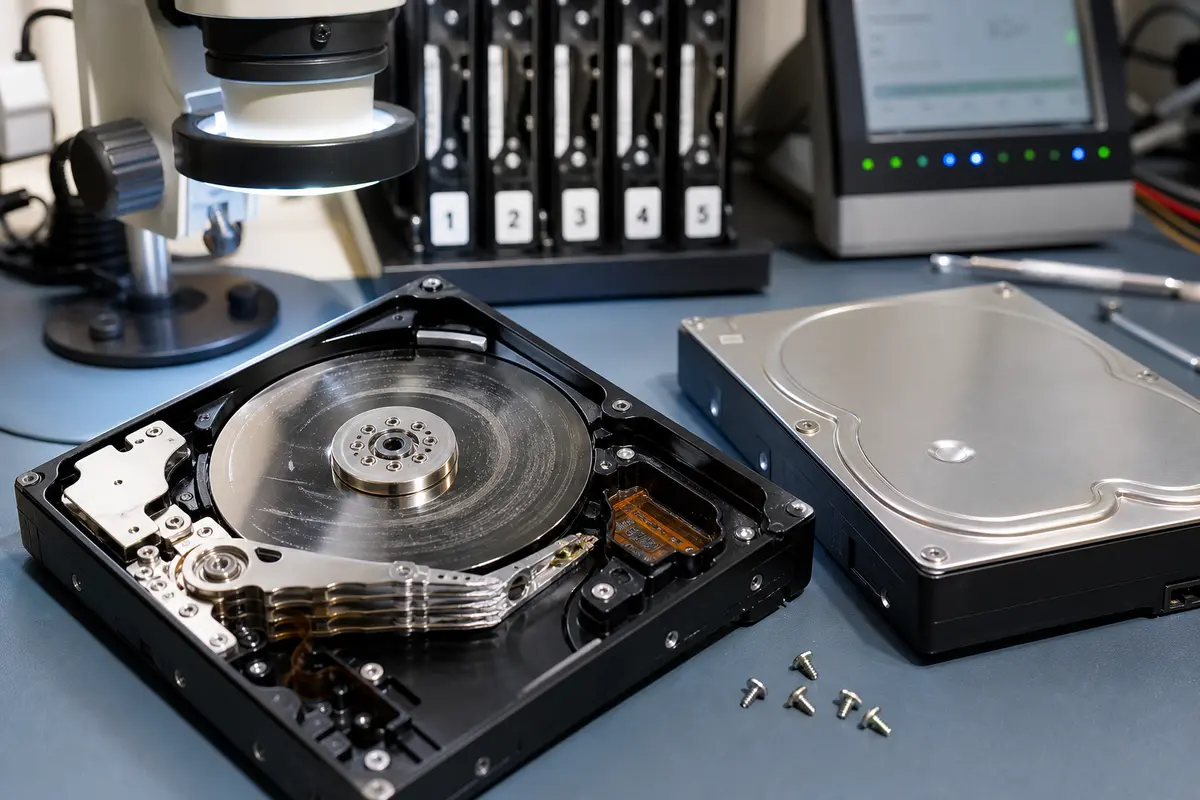
Šance podle úrovně RAID
Každá úroveň selhává jinak a záchrana na ni navazuje jinou technikou.
| Úroveň | Toleruje výpadek | Co rozhoduje o záchraně |
|---|---|---|
| RAID 0 | žádný | fyzická oprava vadného disku a poskládání bloků ze všech členů |
| RAID 1 | jeden disk ze zrcadla | vyčtení alespoň jednoho funkčního média |
| RAID 5 | jeden disk | pořadí disků, stripe size a rotace parity |
| RAID 6 | dva disky | totéž, ale se dvěma paritními rovinami — dopočet je násobně složitější |
| RAID 10 | víc disků, pokud nejsou ve stejném zrcadlovém páru | který pár shodil stripe |
| RAID 50 / 60 | dle vnořené struktury | analýza vnořené struktury pole |
- RAID 0 nemá redundanci: výpadek jediného disku znamená ztrátu všech dat, protože soubory jsou rozsekané po všech discích. Záchrana je složitá, ale ne nemožná — vadný disk musíme fyzicky opravit (typicky výměnou čtecích hlav v čistém laminárním boxu), naklonovat a bloky poskládat offline. Absence parity zjednodušuje matematiku, zato zvyšuje tlak na dokonalou hardwarovou opravu.
- RAID 1 přežije výpadek jednoho disku bez omezení funkčnosti. Riziko nastává při selhání řadiče nebo když je vadný i zbylý disk v zrcadle.
- RAID 5 jede v degraded režimu dál dopočítáváním dat z parity — což je enormní zátěž pro zbylé disky. Když při tom vyskočí vadný sektor na druhém disku, pole přejde do offline a nastupuje analytická rekonstrukce.
- RAID 6 je standard pro velké enterprise NAS. Katastrofa obvykle nepřichází ztrátou dvou disků, ale až při rebuildu, kdy selže třetí — přesně to popisuje náš případ 20-diskového pole.
Co NEdělat
- Neopakujte rebuild degradovaného pole. Když rebuild selhal jednou, selže znovu — a zátěž s každým dalším pokusem zabíjí „zdravé” disky.
- Neprohazujte disky metodou pokus-omyl. U offline pole musíte znát přesné pořadí. Před vytažením označte pozice (Slot 1, Slot 2…) a vyfoťte zadní stranu boxu.
- Nepouštějte chkdsk ani fsck na členy pole. Jednotlivý disk vytažený z RAIDu nenese celý souborový systém — kontrola disku buď nenajde nic, nebo zapíše „opravy” do struktur, které patří jinam.
- Neinstalujte „RAID recovery” software na živé pole. Každý zápis navíc — logy, dočasné soubory — přepisuje zbytky původních struktur. Rekonstrukční nástroje patří výhradně nad kopie disků.
- Neinicializujte pole a nevytvářejte nové. „Create”, „Initialize”, „Format” i „Clear foreign configuration” přepíší metadata (superbloky mdadm, hlavičky LVM, popis pole v řadiči), bez kterých se pořadí disků, stripe size a rotace parity dohledávají mnohem hůř.
- Nepoužívejte „Repair” ani „Factory Reset” a neprovádějte upgrade firmwaru DSM/QTS. Tím smažete zbytky popisu souborového systému.
- Nezapisujte do pole. Když se potřebujete podívat, připojujte výhradně read-only (
mount -o ro). Platí i pro „jen jeden soubor si zkopíruju”.
Pokud jste už něco z toho udělali, zastavte se — stav bývá i přesto řešitelný, ale pole je nutné okamžitě vypnout.
Kdy rozhodují hodiny
Nejde o marketingovou naléhavost, ale o to, co se s poli reálně děje:
- Degradované pole nenechávejte běžet do zítřka. Když spadl jeden disk, „vypneme server až ráno” je ruleta o to, jestli druhý disk přežije další hodinu.
- Rebuild, který běží nad podezřelým polem, pracuje proti vám. V našem případu 20-diskového RAID 6 selhal disk #7 v pondělí, druhý disk #12 v úterý — a rebuild, který mezitím běžel, se po 30 hodinách zakousl na vadném sektoru zdánlivě zdravého disku #5. Ve středu bylo pole offline.
- Cvakání, pískání nebo dokola se roztáčející disk znamená mechanickou vadu. Každé další zapnutí je další přejezd hlav po povrchu a nevratná ztráta právě těch dat, o která jde.
- Spadlý nebo zaseknutý rebuild už podruhé neproběhne lépe, jen s horším výchozím stavem disků.
Laboratoř máme v Brně, příjem disků i konzultace běží NONSTOP na +420 775 556 063.
Jak probíhá záchrana RAID v naší laboratoři
Nehádáme — postupujeme tak, aby byl každý krok vratný.
- Bezplatná diagnostika. Zjistíme rozsah poškození a jestli jde o čistě logický problém (smazaná metadata), nebo jsou nutné fyzické opravy. Cenu říkáme před zahájením prací, ne po nich.
- Sector-level klonování každého člena pole. Zdravý, vadný i klepající disk připojíme na hardwarové klonovače (DeepSpar Disk Imager), které čtou nestabilní povrchy citlivě, přeskakují vadné sektory a netrápí disky časovými limity operačního systému. S originály se dál nepracuje.
- Práce v čistém prostředí. Pokud mechanika fyzicky selhala (cvakání, spálená elektronika), měníme čtecí hlavy v laminárním boxu — bez něj by mikroskopické smítko prachu okamžitě rozbilo plotnu.
- Offline analýza layoutu. Určíme skutečné pořadí disků (fyzické sloty často neodpovídají pořadí parity v řadiči), dopočítáme stripe size a offset — i posun o jediný sektor znamená zmatenou změť bajtů — a odhalíme rotaci parity (left-symmetric, right-asymmetric apod.).
- Virtuální rekonstrukce. Pomocí PC-3000 a vlastních skriptů skládáme pole z bitových kopií a výsledný virtuální svazek kontrolujeme na stagingovém úložišti (120 TB SATA RAID 10), než se ho dotkne zákazník.
Máte-li konkrétní zařízení, platí navíc specifika daného výrobce:
- Jak vytáhnout data z NAS — praktický postup, když NAS umře: jednodiskový vs. RAID, co (ne)klikat
- Záchrana dat ze Synology NAS — SHR, DSM, btrfs a „Volume crashed”
- Záchrana dat z QNAP NAS — QTS, thin/thick volume, „Volume is not active”
- Server s hardwarovým RAID řadičem — HP ProLiant, Dell PERC, VMware VMFS
Reálný případ: 20-diskový RAID 6 ze 160TB NAS
Brněnská projekční firma, enterprise NAS s 20 disky v RAID 6, kapacita pole 160 TB, stáří čtyři roky. V pondělí selhal disk #7, v úterý druhý disk #12 (pole ve stavu degraded-critical) a rozjetý rebuild se po 30 hodinách zasekl na vadném sektoru disku #5. Ve středu bylo pole běžnými prostředky neobnovitelné.
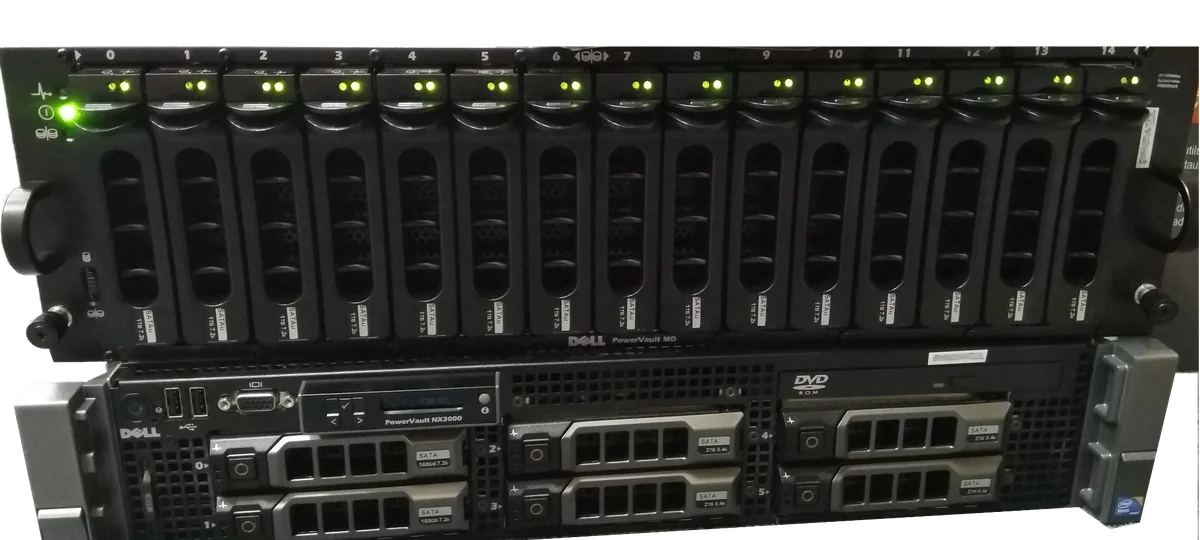
Převzali jsme všech 20 disků, naklonovali je přes DeepSpar (u disku #5 a #7 se špatným povrchem s různými strategiemi čtení), offline analýzou odhalili proprietární layout pole, skutečné pořadí disků, stripe offset a rotaci parity a virtuální pole sestavili z klonů. Výsledek: 100 % dat obnoveno za 11 dní laboratorní práce — a klient nebyl bez dat ani jeden den, protože aktuální projekty priority A jsme z naklonovaných oblastí vytáhli už v prvních třech dnech.
Celý průběh den po dni: case study 20-diskového RAID 6 v NAS.
Kolik to stojí a jak dlouho to trvá
Cena se vždy odvíjí od konkrétní situace — orientační rozpětí podle typu závady a velikosti pole najdete v ceníku záchrany dat. Postupujeme fér: diagnostika je zdarma, rozpočet dostanete před zahájením prací a pokud data zachránit nelze, neplatíte ani korunu.
Délka závisí na kapacitě pole a stavu ploten — nejpomalejší je práce s fyzicky vadnými mechanikami. Obecně platí, že čím méně amatérských pokusů o rebuild pole zažilo, tím je záchrana rychlejší i levnější.
Časté otázky o RAID a NAS
Můžu rebuild spustit sám? Když je pole jen degradované, všechny zbylé disky mají čistý SMART (nula reallokovaných i čekajících sektorů, žádné timeouty) a máte zálohu ověřenou obnovením vzorku, je výměna disku a rebuild běžný provozní úkon. Jakmile má kterýkoli zbylý disk čekající sektory, rostoucí počet reallokací nebo se z něj čte pomalu, rebuild ho při čtení všech sektorů pravděpodobně dorazí.
Pole je degradované a ještě jede. Mám z něj kopírovat data? Ano, to je u degradovaného pole nejlepší první krok — zastavit zápisy a data v klidu zkopírovat pryč, ne spouštět rebuild. Pokud chcete pokusy o sestavení dělat vratné, potřebujete nejdřív sektorové obrazy všech členů, a tedy zhruba součet jejich hrubých kapacit volného místa. Právě na tom většina vlastních pokusů končí.
Můžu na disky pustit chkdsk nebo „RAID recovery” software? Na jednotlivé disky vytažené z pole ne — samostatný člen nenese celý souborový systém a kontrola disku do něj zapíše opravy struktur, které tam nepatří. Na sestavený, ale nekonzistentní svazek také ne: chkdsk odstraní to, co vyhodnotí jako nesrovnalosti, tedy vaše soubory. Rekonstrukční software pouštějte výhradně nad kopiemi disků.
Co k vám mám přivézt — celý NAS, nebo jen disky? Ideálně celý NAS i s disky ve slotech. Když musíte disky vytáhnout, označte pozice fixem nebo štítkem a vyfoťte zadní stranu boxu — pořadí disků je pro rekonstrukci klíčové. Rekonstrukci pak děláme offline z klonů, mimo původní NAS i řadič. Svoz nebo bezpečný transport do Brna domluvíme.
Kdy mám s vlastními pokusy přestat? Jakmile vypadne druhý disk v RAID 5 nebo třetí v RAID 6, jakmile některý disk cvaká, píská nebo se dokola roztáčí, a jakmile rebuild spadl nebo se zasekl na pár procentech. Ve všech třech případech další zapnutí šance jen snižuje. Pole vypněte, disky nechte ve stejných slotech a domluvte diagnostiku.
Konzultace RAID záchrany · Ceník · +420 775 556 063 (NONSTOP)