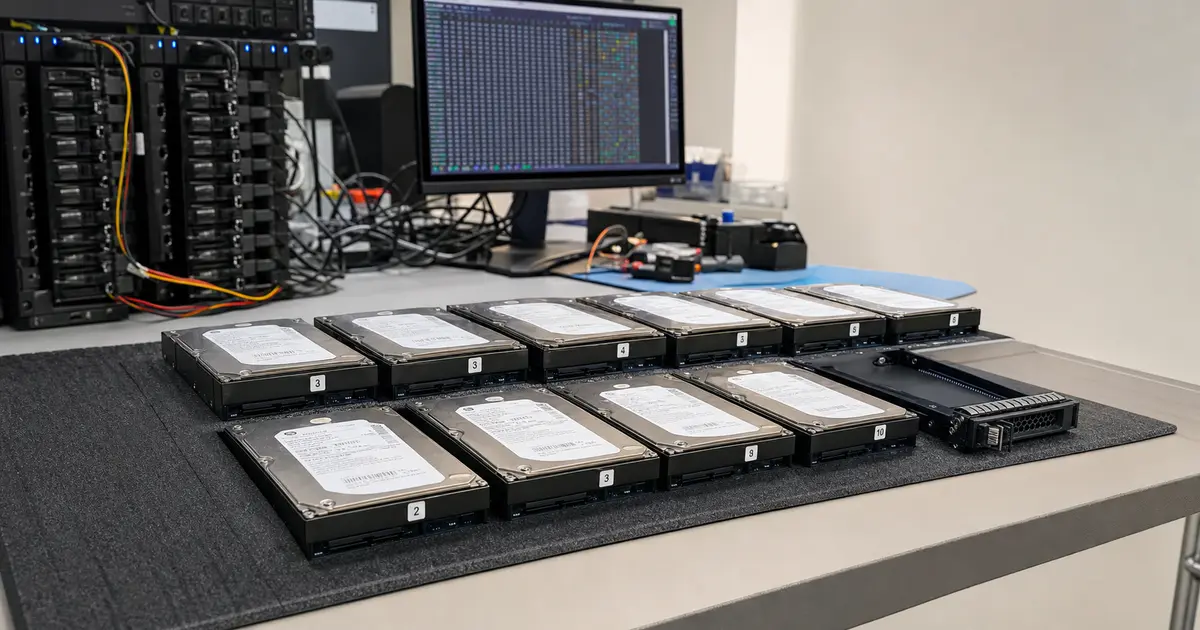
Die Antwort vorweg: Eine Diagnose können Sie selbst sicher durchführen, eine Reparatur nicht. Stellen Sie fest, ob das Array lediglich degradiert ist (es läuft, aber ohne vollständige Redundanz) oder vollständig ausgefallen ist (offline, das Volume lässt sich nicht zusammensetzen). Lesen Sie die SMART-Werte jeder Festplatte aus und notieren Sie die Reihenfolge der Einschübe. Bevor Sie irgendetwas starten, erstellen Sie ein Sektorabbild jeder Festplatte — erst dadurch werden Ihre Versuche rückgängig zu machen. Starten Sie einen Rebuild nur, wenn alle verbliebenen Festplatten weder neu zugewiesene noch ausstehende Sektoren aufweisen und ein Backup vorhanden ist. Eine zweite defekte Festplatte, Klickgeräusche oder ein abgebrochener Rebuild bedeuten das Ende eigener Versuche.
Die meisten ausgefallenen Arrays, die bei uns eintreffen, sind nicht von selbst zusammengebrochen — sie fielen beim zweiten oder dritten Rebuild-Versuch aus. Deshalb beginnen wir damit, was sinnvoll geprüft werden kann, und vor allem damit, wo die Grenze liegt. Bei konkreten Geräten wie Synology, QNAP oder einem Server mit Hardwarecontroller gelten zusätzlich die Besonderheiten des jeweiligen Herstellers. Einzelheiten finden Sie auf der Seite RAID- und NAS-Datenrettung. Sie können die Festplatten aus dem Array in unser Labor in Brno-Židenice bringen oder einsenden — der Transport zu uns ist kostenlos, eine einfache Erstbewertung kann kostenlos sein und eine aufwendigere Analyse kalkulieren wir vorab. Rufen Sie gern zunächst rund um die Uhr unter +420 775 556 063 an oder senden Sie eine Anfrage zur RAID-Datenrettung.
Dienstleistung: Unser Labor rekonstruiert das Array und rettet die enthaltenen Daten — Datenrettung aus einem RAID-Array (Ablauf, Preis nach Diagnose, Annahme rund um die Uhr). Dieser Artikel erklärt, was Sie prüfen und was Sie keinesfalls starten sollten, bevor Sie das Array übergeben.
Was Sie selbst versuchen können
Eine vollständige Diagnose und Vorbereitung lässt sich in Eigenregie durchführen — und das ist bei einem ausgefallenen Array bereits ein Großteil der wertvollen Arbeit. Gefährlich sind Eingriffe, die sich nicht rückgängig machen lassen.
Was Sie nicht tun sollten
- Starten Sie keinen Rebuild mit einer verdächtigen Festplatte. Ein Rebuild zwingt den Controller, jeden Sektor aller verbliebenen Festplatten zu lesen. Eine Festplatte, die im normalen Betrieb jahrelang funktioniert hat, weil nie auf ihre Schwachstellen zugegriffen wurde, kann unter dieser Belastung ausfallen. Ausführlich erläutern wir das im Artikel Warum ein Rebuild ein RAID-Array zerstören kann.
- Initialisieren Sie das Array nicht und erstellen Sie kein neues. „Create“, „Initialize“, „Format“ oder bei einem Hardwarecontroller „Clear foreign configuration“ — all diese Aktionen überschreiben Metadaten wie mdadm-Superblöcke, LVM-Header oder die Array-Beschreibung im Controller. Ohne diese Informationen lassen sich Festplattenreihenfolge, Stripe-Größe und Paritätsrotation erheblich schwerer ermitteln. „Import foreign config“ ist weniger destruktiv, doch die Funktion ohne dokumentierten Ausgangszustand blind zu bestätigen, ist ein Glücksspiel.
- Führen Sie weder chkdsk noch fsck auf den Array-Mitgliedern aus. Eine einzelne, aus dem RAID entnommene Festplatte enthält nicht das vollständige Dateisystem. Die Datenträgerprüfung findet daher entweder nichts oder schreibt vermeintliche „Reparaturen“ in Strukturen, die an eine andere Stelle gehören. Führen Sie chkdsk ebenso wenig auf einem Volume aus, das nur teilweise zusammengesetzt wurde — was das Programm als Unstimmigkeit bewertet, löscht es oder verschiebt es bestenfalls nach found.000.
- Schreiben Sie nichts auf das Array. Wenn Sie den Inhalt überhaupt prüfen müssen, binden Sie das Array ausschließlich schreibgeschützt ein (
mount -o ro). Das gilt ausnahmslos auch dann, wenn Sie „nur eine einzige Datei kopieren“ möchten. - Vertauschen Sie Festplatten nicht nach dem Prinzip Versuch und Irrtum. Kennzeichnen Sie vor dem Herausnehmen die Einschübe mit einem Stift oder Etikett und fotografieren Sie die Rückseite des Gehäuses.
Was Sie überprüfen sollten
- SMART-Werte jeder Festplatte. Idealerweise prüfen Sie die Festplatte außerhalb des Arrays und direkt über SATA oder einen HBA:
smartctl -a /dev/sdaaus dem Paket smartmontools. Hinter einem Hardwarecontroller verwenden Sie beispielsweisesmartctl -a -d megaraid,0 /dev/sda. Relevant sind die Attribute 5 Reallocated_Sector_Ct, 197 Current_Pending_Sector, 198 Offline_Uncorrectable, 187 Reported_Uncorrect und 188 Command_Timeout. Jeder Wert ungleich null bei 197 oder 198 bedeutet, dass die Festplatte unlesbare Bereiche besitzt und der Rebuild dort scheitern wird. Attribut 199 UDMA_CRC_Error_Count weist dagegen häufig lediglich auf ein Kabel oder eine Backplane hin. Ein kurzer Selbsttest (smartctl -t short) ist bei Festplatten ohne ausstehende Sektoren vertretbar; starten Sie weder einen langen Test noch einen Selbsttest auf einer klickenden Festplatte. - Degradiert oder ausgefallen. Ein degradiertes Array läuft und die Daten sind zugänglich; lediglich die Redundanz fehlt.
mdadm --detail /dev/md2meldetState : clean, degraded, das NAS zeigt „Degraded“ oder „Snížená ochrana“ an. Ein ausgefallenes Array lässt sich nicht zusammensetzen, das Volume fehlt,cat /proc/mdstatzeigtinactiveund der Controller meldet Offline oder Failed. Davon hängt das weitere Vorgehen ab: Bei einem degradierten Array sollten Sie zuerst die Daten auf ein anderes Medium kopieren; bei einem ausgefallenen Array sollten Sie ohne Festplattenkopien nichts unternehmen. - Reihenfolge der Festplatten und Aktualität der Daten.
mdadm --examine /dev/sda3zeigt für jedes Mitglied unter anderem Array UUID, Raid Level, Device Role, Data Offset, Chunk Size und vor allem Events an. Eine Festplatte mit einem deutlich niedrigeren Ereigniszähler ist zuerst aus dem Array ausgefallen und enthält einen älteren Datenstand. Sie als gültiges Mitglied zurückzuholen würde unterschiedlich alte Datenstände vermischen. Speichern Sie die Ausgaben, anstatt sie abzuschreiben.
Warum Sie zuerst ein Abbild jeder Festplatte benötigen
Jeder Versuch, das Array zusammenzusetzen, jeder Rebuild und jedes „Ich lasse es noch einmal hochfahren“ kann Schreibvorgänge auslösen — und ein Schreibvorgang ist nicht rückgängig zu machen. Ein Sektorabbild macht aus einem unumkehrbaren Eingriff einen wiederholbaren Versuch: Sie können fünf Varianten der Festplattenreihenfolge und Stripe-Größe testen und jederzeit zum Ausgangspunkt zurückkehren.
Verwenden Sie ddrescue mit einer Mapfile, nicht dd. dd bleibt am ersten unlesbaren Sektor hängen oder füllt den Fehler mit Nullen auf, ohne Sie über die problematischen Stellen zu informieren. Führen Sie zunächst einen schnellen Durchlauf ohne Wiederholungsversuche aus:
ddrescue -n /dev/sda /mnt/kopie/disk1.img /mnt/kopie/disk1.map
Erst danach folgt mit derselben Mapfile ein Durchlauf mit Wiederholungen (-r1). Schließen Sie die Festplatten direkt über SATA oder einen HBA an; USB-Adapter verbergen SMART-Daten und setzen sich bei Fehlern zurück.
Die praktische Grenze: Sie benötigen ungefähr die Summe der Bruttokapazitäten aller Array-Mitglieder. Bei vier Festplatten mit jeweils 4 TB ist das noch lösbar, bei zwanzig Festplatten mit jeweils 8 TB nicht ohne Weiteres — und genau hier enden die meisten eigenen Versuche.
Wann ein eigener Versuch vertretbar ist
Er ist nur sinnvoll, wenn alle folgenden Voraussetzungen gleichzeitig erfüllt sind:
- Das Array ist degradiert, nicht offline, und die Daten sind zugänglich.
- Alle verbliebenen Festplatten haben unauffällige SMART-Werte und lassen sich mit voller Geschwindigkeit lesen.
- Sie besitzen ein Backup, das Sie durch die Wiederherstellung mindestens einer Stichprobe von Dateien überprüft haben.
- Es handelt sich um einen einfachen Fall: RAID 1 mit einer intakten Festplatte, die sich separat und schreibgeschützt auslesen lässt, oder RAID 5 mit genau einer defekten Festplatte.
Ein eigener Versuch ist nicht sinnvoll bei einem RAID 5, das nach dem Ausfall der zweiten Festplatte zusammengebrochen ist, bei RAID 6 nach dem dritten Ausfall, bei Arrays mit einer klickenden Festplatte, bei proprietären Layouts mit unbekannten Parametern und überall dort, wo Sie sich einen Datenverlust nicht leisten können oder keinen Speicherplatz für Kopien haben.
STOPP-Punkt: Wann Sie die Versuche beenden müssen
Drei Situationen bedeuten das Ende eigener Versuche. Nicht „noch einmal vorsichtig“, sondern ausschalten und ausgeschaltet lassen:
- Bei RAID 5 ist die zweite Festplatte ausgefallen, bei RAID 6 die dritte. Die fehlenden Daten lassen sich nicht mehr vollständig berechnen — die Parität reicht dafür nicht aus. Der einzige Weg führt über das physische Auslesen der defekten Festplatte.
- Eine Festplatte klickt, pfeift, dreht immer wieder hoch oder wird überhaupt nicht erkannt. Das ist ein mechanischer Defekt. Jedes weitere Einschalten verursacht zusätzliche Bewegungen der Köpfe über die Oberfläche und kann genau die benötigten Daten unwiederbringlich zerstören.
- Der Rebuild ist abgebrochen oder hängt fest. Ein weiterer Versuch wird genauso verlaufen, nur mit einem schlechteren Ausgangszustand der Festplatten.
Weitere Warnzeichen sind eine zunehmende Zahl von Fehlern beim Kopieren, eine aus dmesg verschwindende Festplatte, eine rapide sinkende Lesegeschwindigkeit oder der Geruch verbrannter Elektronik. In allen Fällen gilt: Array ausschalten, Festplatten gekennzeichnet in denselben Einschüben belassen und keine weiteren Versuche unternehmen.
Schnelle Orientierung: RAID-Reparatur nach Symptom
Der Begriff „RAID-Reparatur“ legt nahe, das Array müsse möglichst schnell wieder in Betrieb genommen werden. Ist das Array jedoch zusammengebrochen — es meldet Degraded oder Offline oder ist während des Rebuilds ausgefallen — besteht das erste Ziel darin, die Daten aus dem defekten RAID-Array zu sichern. Erst danach sollte ein neues Speichersystem eingerichtet werden. Gehen Sie je nach Symptom folgendermaßen vor:
- RAID meldet Degraded: Starten Sie keinen neuen Rebuild, solange nicht feststeht, dass alle anderen Festplatten vollständig lesbar sind. Prüfen Sie zuerst das Backup, stoppen Sie Schreibvorgänge und lassen Sie den Zustand beurteilen.
- Der Rebuild hängt oder ist abgebrochen: Schalten Sie das Array aus. Ein wiederholter Rebuild verschlimmert typischerweise die Schäden an den verbleibenden Festplatten.
- RAID 5 ist nach dem zweiten Festplattenausfall offline: Versuchen Sie nicht, die ursprüngliche Konfiguration wieder „hochzufahren“. Bei RAID 5 sind die genaue Festplattenreihenfolge, die Stripe-Größe und das Paritätsschema entscheidend.
- RAID 6 ist beim dritten Problem ausgefallen: Belassen Sie die Festplatten in denselben Einschüben, kennzeichnen Sie ihre Positionen und führen Sie eine Offline-Rekonstruktion aus Klonen durch.
- RAID 0 nach einem Festplattenausfall: Die Daten sind nicht redundant. Wenn die defekte Festplatte jedoch physisch ausgelesen oder repariert werden kann, lässt sich die Struktur des Arrays rekonstruieren.
Darin unterscheidet sich eine betriebliche „RAID-Reparatur“ von der professionellen Datenrettung aus einem RAID-Array. Die erste versucht, das Gerät wieder in Betrieb zu nehmen; die zweite schützt die noch auf den Festplatten vorhandenen Inhalte.
1. Der Mythos „RAID = Backup“
Bevor wir in technische Details einsteigen, müssen wir mit dem gefährlichsten Mythos der Branche aufräumen. Ein RAID-Array (Redundant Array of Independent Disks) wurde nie als Backup konzipiert. Es soll die Verfügbarkeit erhöhen und gegen den Hardwareausfall einer oder mehrerer Festplatten schützen.
Warum ist RAID kein Backup?
- Es schützt nicht vor dem versehentlichen Löschen von Dateien.
- Es schützt nicht vor Ransomware, die den Inhalt des logischen Volumes verschlüsselt.
- Es hilft nicht bei einem Controllerdefekt, durch den fehlerhafte Metadaten auf das Array geschrieben werden.
- Es versagt bei einer versehentlichen Neuinitialisierung oder beim Erstellen eines neuen Arrays.
Fällt das gesamte Array wegen eines Firmwarefehlers, einer Überspannung oder mehrerer gleichzeitiger Festplattenausfälle aus, sind Ihre Daten genauso unzugänglich, als hätten sie nur auf einer einzelnen externen Festplatte gelegen. Ein echtes Backup ist eine physisch getrennte Kopie der Daten — idealerweise an einem anderen Standort oder auf einem anderen Medium. Sobald das Array den Zustand „Offline“ erreicht, erfordert seine Wiederherstellung unabhängig von der verwendeten RAID-Stufe einen fachkundigen Eingriff.
2. RAID-Level und ihre tatsächliche Ausfallsicherheit
Die RAID-Level unterscheiden sich in ihrer Fehlertoleranz. Für die RAID-Datenrettung ist entscheidend zu verstehen, was während eines Ausfalls im Array geschieht.
RAID 0 — Striping ohne Ausfallsicherheit
Die Daten werden zur Maximierung der Leistung abwechselnd in Stripes auf alle Festplatten geschrieben.
- Ausfallsicherheit: keine. Der Ausfall einer einzigen Festplatte führt zum Verlust aller Daten, weil jede Datei in Fragmente zerlegt über alle Festplatten verteilt ist.
- RAID-0-Datenrettung: Sie ist anspruchsvoll, aber nicht unmöglich. Wir müssen die defekte Festplatte physisch reparieren, beispielsweise durch einen Austausch der Leseköpfe in einer Reinraumwerkbank, sie klonen und anschließend die Datenblöcke aller Festplatten offline in der richtigen Reihenfolge zusammensetzen. Das Fehlen der Parität vereinfacht die Mathematik, die fehlende Redundanz erhöht jedoch die Anforderungen an eine erfolgreiche Hardware-Reparatur.
RAID 1 — Spiegelung
Die Daten werden gleichzeitig auf beide Festplatten oder auf mehrere Spiegelpaare geschrieben. Der Ausfall einer Festplatte beeinträchtigt die Funktion nicht. Ein Risiko entsteht, wenn der Controller ausfällt oder auch die verbliebene Festplatte eines Spiegelpaars defekt ist. Die Rettung besteht häufig lediglich darin, die Daten von mindestens einem funktionsfähigen Datenträger auszulesen.
RAID 5 — Blockparität
Dank verteilter Parität toleriert das Array den Ausfall einer Festplatte.
- Degradierter Modus: Nach einem Festplattenausfall läuft das Array weiter und berechnet die fehlenden Daten aus der Parität. Das belastet die verbleibenden Festplatten enorm.
- Fehlgeschlagene Wiederherstellung: Scheitert der Rebuild im degradierten Zustand, etwa wegen eines defekten Sektors auf einer zweiten Festplatte, wechselt das gesamte Array in den Offline-Zustand. Dann muss ermittelt werden, wo die Stripes beginnen und wie die Parität rotiert — hier kommt die analytische Rekonstruktion im Labor zum Einsatz.
RAID 6 — doppelte Parität
RAID 6 toleriert den gleichzeitigen Ausfall von zwei Festplatten und ist ein gängiger Standard für große Enterprise-NAS-Systeme.
- Szenario aus der Praxis: Auch wenn das Array den Verlust zweier Festplatten übersteht, tritt die Katastrophe häufig während des Rebuilds ein, wenn eine dritte Festplatte ausfällt. Ein reales Beispiel mit einem Array aus 20 Festplatten beschreiben wir weiter unten. Wegen der beiden Paritätsebenen ist die Offline-Berechnung außerordentlich komplex.
RAID 10 — gespiegelte Stripes
RAID 10 kombiniert die Geschwindigkeit von RAID 0 mit der Redundanz von RAID 1. Das Array kann den Ausfall mehrerer Festplatten überstehen, sofern diese nicht zum selben Spiegelpaar gehören. Fallen beide Festplatten eines Spiegelpaars aus, bricht der gesamte Stripe-Verbund zusammen.
RAID 50/60
Kurz zusammengefasst: Diese Level kombinieren Striping und Parität. Die verschachtelte Struktur vervielfacht die Komplexität der Datenrettung und erfordert eine fortgeschrittene Analyse.
3. Typische Ausfallszenarien aus unserem Laboralltag
In unserem Labor in Brno begegnen uns immer wieder dieselben Abläufe, die schließlich zur Katastrophe führen. Wenn Sie verstehen, was passiert ist, wird auch klar, warum sich ein RAID nicht einfach durch einen Klick im BIOS „reparieren“ lässt.
(a) Ausfall der zweiten Festplatte während des Rebuilds
Der Administrator ersetzt die defekte Festplatte. Damit der Controller die Daten auf der neuen Festplatte rekonstruieren kann, muss er jeden Sektor aller verbliebenen Platten lesen. Alte Festplatten, die jahrelang fehlerfrei liefen, offenbaren unter dieser extremen Belastung plötzlich schwache Bereiche und liefern defekte Sektoren. Das Array fällt vollständig aus.
(b) Festhängender Rebuild
Der Rebuild startet nicht oder bleibt nach Dutzenden Stunden bei wenigen Prozent stehen. Der Controller ist auf einen defekten Sektor gestoßen und weiß nicht, wie er ihn umgehen soll. Den Vorgang mit Gewalt fortzusetzen kann die Mechanik der Leseköpfe zerstören.
(c) Controllerausfall und proprietäres Layout
Ein ausgefallener Controller kann die Metadaten beschädigen. Ein neuer Controller erkennt die Festplatten möglicherweise, kennt aber den ursprünglichen Stripe-Offset und die Paritätsrotation nicht. Dann bietet er lediglich „Foreign configuration“ und eine Initialisierung an.
(d) Menschlicher Fehler
Jemand trennt versehentlich die falsche Festplatte, vertauscht die Positionen in den Einschüben und startet das Array. Oder er führt nach einer Fehlermeldung eine Neuinitialisierung durch.
(e) Gleichzeitiger Ausfall mehrerer Festplatten
Ein defektes Netzteil oder eine fehlerhafte Backplane im NAS beschädigt gleichzeitig drei oder vier Festplatten. Das Array zeigt die logische Einheit anschließend als leer oder unzugänglich an.
4. Was Sie keinesfalls tun dürfen, wenn die Daten gerettet werden sollen
Dies ist der wichtigste Abschnitt des Artikels. Die meisten endgültig verlorenen Daten verschwanden erst durch panische Versuche, das RAID in Eigenregie zu reparieren.
- Wiederholen Sie niemals den Rebuild eines degradierten Arrays. Wenn der Rebuild einmal fehlgeschlagen ist, wird er erneut scheitern — und die Belastung schädigt mit jedem weiteren Versuch die vermeintlich „gesunden“ Festplatten. Genau dieses Szenario brachte das unten beschriebene Array aus 20 Festplatten zum Absturz.
- Vertauschen oder ersetzen Sie Festplatten nicht nach dem Prinzip Versuch und Irrtum. Bei einem Offline-Array müssen Sie die genaue Reihenfolge der Festplatten kennen. Zufälliges Umstecken in den Einschüben zerstört die Chancen auf eine logische Rekonstruktion. Kennzeichnen Sie vor dem Herausnehmen immer die Positionen (Slot 1, Slot 2 …).
- Installieren Sie keine „RAID-Recovery“-Software auf dem aktiven Array. Starten Sie niemals Wiederherstellungsprogramme wie R-Studio, während das Betriebssystem gleichzeitig auf das Array schreibt. Jeder zusätzliche Schreibvorgang — etwa Protokolle oder temporäre Dateien — überschreibt Reste der ursprünglichen Strukturen.
- Lassen Sie ein degradiertes Array nicht weiterlaufen. Wenn eine Festplatte ausgefallen ist, lassen Sie den Server nicht „bis morgen“ weiterarbeiten. Sie setzen darauf, dass die zweite Festplatte noch eine weitere Stunde übersteht. Stoppen Sie sofort die Schreibvorgänge und lassen Sie sich beraten.
- Verwenden Sie weder „Repair“ noch „Factory Reset“. Führen Sie kein Firmware-Upgrade von DSM oder QTS durch und initialisieren Sie kein neues logisches Volume. Dadurch löschen Sie die verbliebenen Beschreibungen des Dateisystems.
Wenn Sie bereits eine dieser Aktionen durchgeführt haben, halten Sie jetzt an. Der Zustand lässt sich häufig trotzdem noch bearbeiten, doch das Array muss sofort ausgeschaltet werden.
5. Wie ein professionelles Labor ein RAID-Array wiederherstellt
Unsere Arbeit beruht nicht auf Raten, sondern auf technischer Präzision. Bevor wir mit der logischen Wiederherstellung beginnen, müssen wir die Daten physisch schützen.
Klonen auf Sektorebene
Wir arbeiten niemals mit den Originalfestplatten. Jede Festplatte des Arrays — ob intakt, defekt oder klickend — wird an Hardware-Kloner wie den DeepSpar Disk Imager angeschlossen. Diese Geräte lesen instabile Oberflächen besonders schonend aus, überspringen defekte Sektoren und belasten die Festplatten nicht mit den Zeitlimits eines Betriebssystems. Wo ein gewöhnlicher Computer einfriert, gewinnt DeepSpar die maximal mögliche Datenmenge.
Arbeit in einer sauberen Umgebung
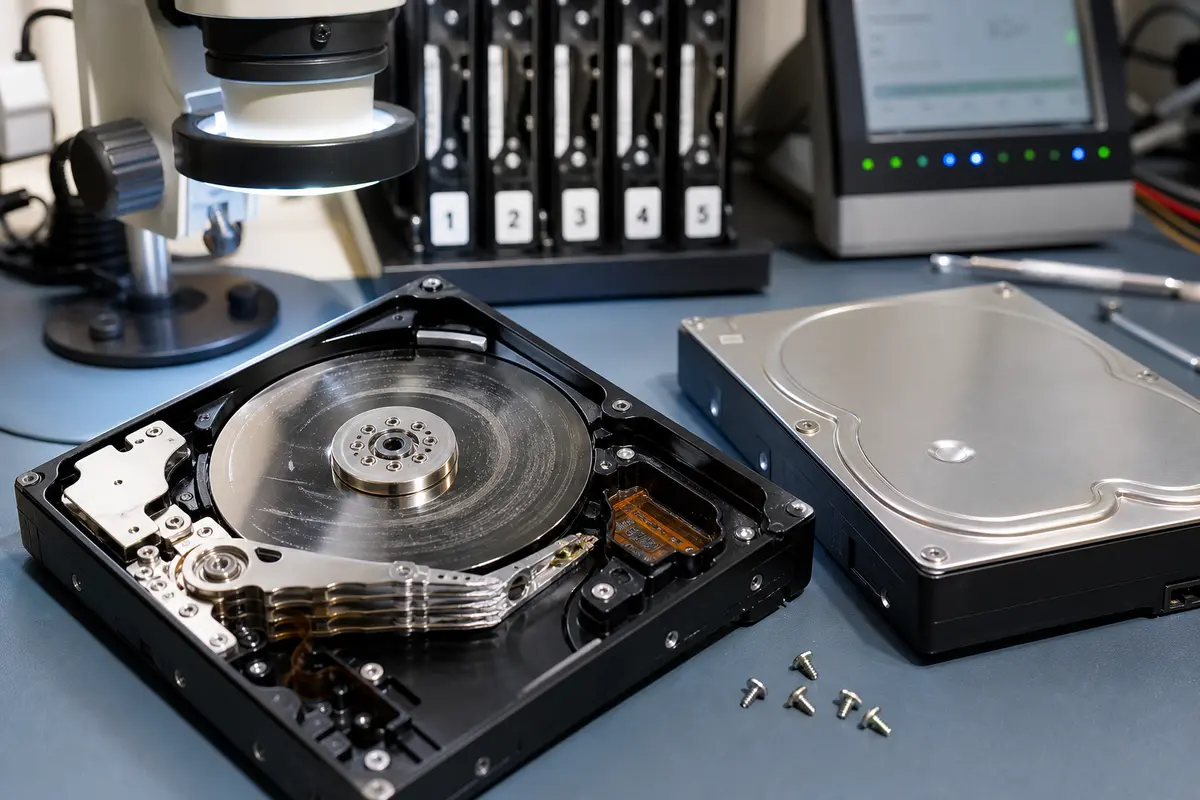
Wenn die Mechanik einer Festplatte physisch ausgefallen ist, etwa bei Klickgeräuschen oder verbrannter Elektronik, tauschen wir die Leseköpfe in einer Reinraumwerkbank aus. Ohne diese Umgebung könnte bereits ein mikroskopisch kleines Staubteilchen die Platter beschädigen.
Offline-Analyse und Entschlüsselung proprietärer Layouts
Nach der Erstellung bitgenauer Kopien beginnt der analytisch anspruchsvollste Teil der Wiederherstellung:
- Bestimmung der Festplattenreihenfolge: Die physischen Einschübe entsprechen häufig nicht der Paritätsreihenfolge im Controller.
- Berechnung von Stripe-Größe und Offset: Wir ermitteln, wo der erste Datenblock beginnt. Bereits eine Verschiebung um einen einzigen Sektor führt zu einem völlig unbrauchbaren Datenstrom.
- Paritätsrotation: Bei RAID 5 und RAID 6 müssen wir bestimmen, in welchem Block die Parität liegt, beispielsweise left-symmetric oder right-asymmetric.
- Virtuelle Rekonstruktion: Mithilfe von PC-3000 und eigenen Skripten setzen wir das Array aus den bitgenauen Kopien zusammen und erstellen ein virtuelles Volume, das wir auf einem Staging-Speicher mit 120 TB SATA RAID 10 überprüfen.
Unser Labor befindet sich in Brno. Die Annahme von Festplatten und telefonische Beratung sind rund um die Uhr unter +420 775 556 063 erreichbar. Bei Synology, QNAP oder einem Server mit Hardwarecontroller gelten zusätzliche Besonderheiten — siehe Datenrettung aus einem Synology NAS, QNAP NAS und Datenrettung aus einem Server.
6. Realer Ausfall eines RAID 6 mit 20 Festplatten — warum es auch Ihnen passieren kann
Ein anschauliches Beispiel ist dieses RAID 6 mit 20 Festplatten, das uns ein Planungsunternehmen aus Brno übergab.
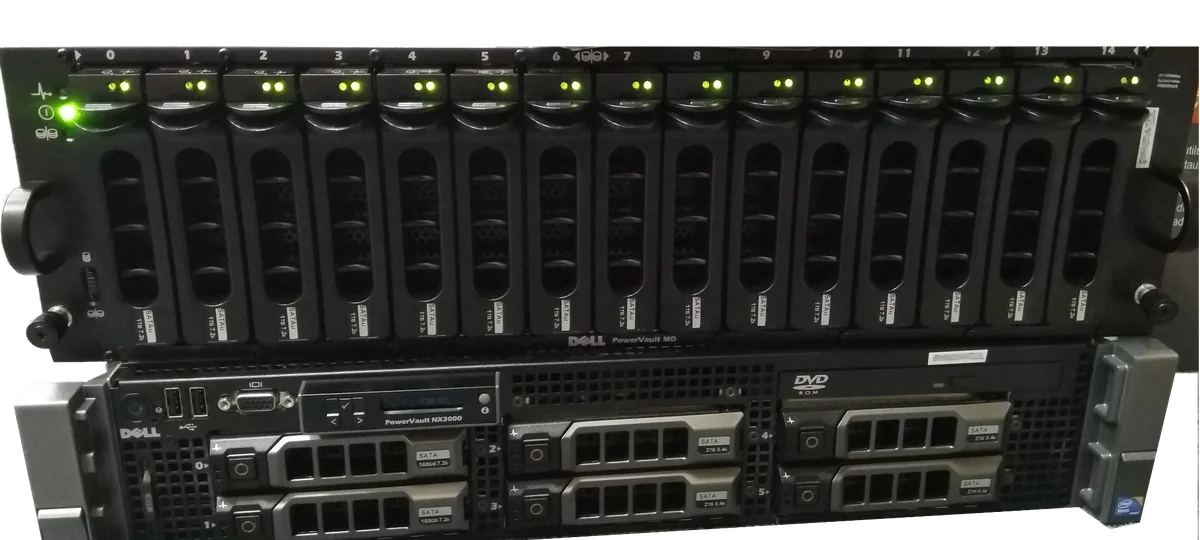
Ausgangslage: Enterprise-NAS, 20 Festplatten, 160 TB, RAID 6 mit doppelter Parität. Am Montag fiel Festplatte Nr. 7 aus. Der Administrator bestellte Ersatz und startete über Nacht einen Rebuild. Am Dienstag fiel die zweite Festplatte, Nr. 12, aus. Das Array erreichte den Zustand „degraded-critical“, in dem jedes weitere Problem das Ende bedeutet. Ein solches Array hätte zwei Tage lang nicht belastet werden dürfen, doch der Rebuild lief weiter. Nach 30 Stunden traf der Lesevorgang auf einen defekten Sektor der vermeintlich „gesunden“ Festplatte Nr. 5. Der Controller wertete dies als Ausfall einer dritten Festplatte und schaltete das Array offline. Mit gewöhnlichen Mitteln war es nicht mehr wiederherstellbar.
Unsere Lösung: Wir übernahmen alle 20 Festplatten. Mit DeepSpar klonten wir sie nacheinander und bewältigten dabei das extrem langsame Lesen von Festplatte Nr. 5. Die Offline-Analyse zeigte ein proprietäres Array-Layout aus mdadm und LVM. Wir bestimmten die tatsächliche Festplattenreihenfolge, den Stripe-Offset und die Paritätsrotation und konnten das virtuelle Array aus den geklonten Sektoren zusammensetzen. Die Arbeit dauerte elf Tage; der Kunde erhielt 100 % seiner Dateien zurück.
Hätte der Administrator einen weiteren Rebuild versucht, wäre Festplatte Nr. 5 vollständig ausgefallen und die RAID-Datenrettung zu einer erheblich teureren physischen Operation geworden.
7. Was kostet die Datenrettung und wie lange dauert sie?
Der Preis einer Datenrettung aus einem RAID-Array hängt immer vom konkreten Fall ab. Eine Orientierung nach Fehlerart und Größe des Arrays finden Sie in unserer Preisliste für Datenrettung. Bei ITHOPE gehen wir transparent vor: Eine Erstbewertung zeigt den Umfang der Beschädigung. Eine einfache Bewertung kann kostenlos sein; die Analyse mehrerer Festplatten sowie die Rekonstruktion des Arrays oder seiner Metadaten kann kostenpflichtig sein und wird vorab kalkuliert. Wir prüfen, ob das Problem rein logisch ist, etwa gelöschte Metadaten, oder ob physische Reparaturen und Klonarbeiten erforderlich sind. Den Preis nennen wir vor Beginn der Arbeiten, niemals erst danach. Lassen sich die Daten nicht retten — was bei zerstörten Metadaten ohne Backup in Einzelfällen vorkommt — bezahlen Sie für die Wiederherstellung keinen Cent.
Die Dauer hängt von der Kapazität und dem Zustand der Platter ab. Am zeitaufwendigsten ist die Arbeit mit physisch beschädigten Mechaniken. Grundsätzlich gilt: Je weniger amateurhafte Rebuild-Versuche vor der Übergabe unternommen wurden, desto schneller und günstiger ist die Datenrettung.
Häufig gestellte Fragen
Kann ich den Rebuild selbst starten?
Wenn das Array lediglich degradiert ist, alle verbliebenen Festplatten unauffällige SMART-Werte aufweisen — also keine neu zugewiesenen oder ausstehenden Sektoren und keine Timeouts — und Sie über ein Backup verfügen, das Sie durch die Wiederherstellung einer Stichprobe überprüft haben, sind der Festplattentausch und der Rebuild übliche Betriebsmaßnahmen. Sobald eine der verbliebenen Festplatten ausstehende Sektoren, eine wachsende Zahl von Neuzuweisungen oder eine geringe Lesegeschwindigkeit zeigt, wird der Rebuild sie beim Lesen sämtlicher Sektoren wahrscheinlich endgültig ausfallen lassen. Dann sollten Sie zuerst sektorweise Kopien der Festplatten anfertigen oder das Array direkt einem Labor übergeben.
Wie unterscheide ich ein degradiertes von einem ausgefallenen Array?
Ein degradiertes Array läuft weiter und die Daten sind zugänglich; es fehlt lediglich die Redundanz. mdadm --detail meldet clean, degraded, das NAS zeigt „Degraded“ oder „Snížená ochrana“ an. Ein ausgefallenes beziehungsweise offline geschaltetes Array lässt sich nicht zusammensetzen, das Volume fehlt, in /proc/mdstat steht das Array auf inactive und der Hardwarecontroller meldet Offline oder Failed. Dieser Unterschied ist entscheidend: Bei einem degradierten Array haben Sie Zeit, die Daten in Ruhe zu kopieren; bei einem ausgefallenen Array ist jeder weitere Start ein Risiko.
Womit erstelle ich Sektorabbilder und wie viel Speicherplatz brauche ich?
Verwenden Sie ddrescue mit einer Mapfile, nicht dd. dd bleibt am ersten unlesbaren Sektor hängen oder füllt den Fehler mit Nullen auf, ohne Ihnen die problematischen Stellen zu zeigen. Führen Sie zunächst mit dem Schalter -n einen schnellen Durchlauf ohne Wiederholungsversuche aus und erst danach einen Durchlauf mit Wiederholungen. Schließen Sie die Festplatten direkt über SATA oder einen HBA an, nicht über einen USB-Adapter, der SMART-Daten verbirgt und sich bei Fehlern zurücksetzt. Sie benötigen ungefähr die Summe der Bruttokapazitäten aller Array-Mitglieder — genau daran scheitern die meisten eigenen Versuche.
Kann ich chkdsk oder „RAID-Recovery“-Software auf die Array-Mitglieder anwenden?
Nicht auf einzelne, aus dem Array entnommene Festplatten. Ein einzelnes Mitglied enthält nicht das vollständige Dateisystem, und eine Datenträgerprüfung würde Reparaturen an Strukturen schreiben, die dort nicht hingehören. Auch auf ein zusammengesetztes, aber inkonsistentes Volume gehört chkdsk nicht: Es entfernt alles, was es als Unstimmigkeit bewertet — also möglicherweise Ihre Dateien. Rekonstruktionssoftware darf ausschließlich auf Kopien der Festplatten arbeiten, niemals auf den Originalen.
Wann sollte ich meine eigenen Versuche beenden?
Sobald bei RAID 5 die zweite oder bei RAID 6 die dritte Festplatte ausfällt, sobald eine Festplatte klickt, pfeift oder immer wieder hochdreht und sobald ein Rebuild abgebrochen wurde oder bei wenigen Prozent festhängt. In allen drei Fällen verringert jedes weitere Einschalten nur die Erfolgsaussichten. Schalten Sie das Array aus, belassen Sie die Festplatten in denselben Einschüben und vereinbaren Sie eine Diagnose.
Was Sie jetzt tun sollten
- Stoppen Sie Schreibvorgänge und schalten Sie das Array aus. Keine weiteren Rebuilds und kein „letzter Versuch“. Jede weitere Betriebsminute eines beschädigten degradierten Arrays verringert die Erfolgsaussichten.
- Ändern Sie die Reihenfolge der Festplatten nicht. Wenn Sie sie herausnehmen müssen, kennzeichnen Sie zuvor die Positionen mit einem Stift oder Etikett (Slot 1, Slot 2 …).
- Starten Sie keine Recovery-Software auf dem aktiven Array und initialisieren Sie weder ein neues Volume noch eine „Foreign config“.
- Kontaktieren Sie das Labor. Rufen Sie rund um die Uhr unter +420 775 556 063 an oder nutzen Sie die unverbindliche Beratung. Wir vereinbaren eine Abholung oder den sicheren Transport nach Brno.
- Rechnen Sie mit einer Diagnose. Eine einfache Erstbewertung kann kostenlos sein; eine aufwendigere Analyse des Arrays kalkulieren wir vorab. Den Umfang der Beschädigung und den Preis der Wiederherstellung nennen wir im Voraus — Sie bezahlen die Wiederherstellung erst bei einem Ergebnis.
Zusammenfassung
- Sie können die Diagnose selbst durchführen, nicht aber die Reparatur: Prüfen Sie die SMART-Werte jeder Festplatte, unterscheiden Sie zwischen einem degradierten und einem ausgefallenen Array, dokumentieren Sie die Einschubreihenfolge und erstellen Sie Sektorabbilder. Erst danach darf ein Rekonstruktionsversuch beginnen.
- RAID ist kein Backup: Es schützt weder vor dem Löschen noch vor Ransomware, einem Controllerausfall oder mehreren gleichzeitigen Festplattenausfällen.
- Die häufigste Ursache eines Totalverlusts ist ein wiederholter Rebuild eines degradierten Arrays, der alte vermeintlich „gesunde“ Festplatten endgültig ausfallen lässt und einen Kaskadenausfall auslöst.
- Jedes RAID-Level fällt anders aus: RAID 0 bietet keine Fehlertoleranz, RAID 5 toleriert eine und RAID 6 zwei ausgefallene Festplatten. Die Rettung hängt stets von Festplattenreihenfolge, Stripe-Offset und Paritätsrotation ab.
- Datenrettung bedeutet sektorweises Klonen jeder Festplatte und Offline-Rekonstruktion, niemals Arbeit an den Originalen.
- Der STOPP-Punkt ist eindeutig: Eine zweite defekte Festplatte, Klickgeräusche oder ein abgebrochener Rebuild bedeuten das Ende eigener Versuche.
- Informationen zu konkreten Geräten finden Sie unter Synology, QNAP und Server mit Hardwarecontroller.
Sie haben den STOPP-Punkt erreicht — eine zweite defekte Festplatte, Klickgeräusche oder einen abgebrochenen Rebuild? Schalten Sie das Array aus und nicht wieder ein. Unverbindliche Beratung · Erstbewertung · Preisliste · Kontakt · +420 775 556 063 (rund um die Uhr)
Siehe auch: Warum ein Rebuild ein RAID-Array zerstören kann · Datenrettung aus einem Synology NAS · QNAP NAS · Datenrettung aus einem Server · RAID- und NAS-Datenrettung (Dienstleistung) · Fallstudie: RAID 6 mit 20 Festplatten · Defekte HDD-Sektoren
Über den Autor
Ing. Miroslav Jaroš ist Inhaber und leitender Techniker der ITHOPE s.r.o. in Brno. Seit 2008 beschäftigt er sich mit Datenrettung — in 18 Jahren bearbeitete das Labor mehr als 2.500 Aufträge, von einzelnen Festplatten bis hin zu Enterprise-RAID-Arrays und NAS-Systemen. Der Artikel wurde von Tomáš Kopřiva anhand der tatsächlichen Arbeitspraxis des ITHOPE-Labors fachlich geprüft. Der beschriebene Fall eines RAID 6 mit 20 Festplatten beruht auf einem realen, anonymisierten Auftrag.
Wo Sie uns finden
ITHOPE ist eine Firma aus Brno, Tschechien: wir machen Datenrettung von Festplatten, RAID und NAS, PC- und Notebook-Service und IT für Unternehmen, alles im eigenen Labor in der Viniční 3587/216, 615 00 Brno.
Telefon +420 775 556 063 (rund um die Uhr). Das Gerät können Sie persönlich bringen oder per Kurier schicken (Zásilkovna, PPL).